
Avant de choisir un modèle, posons le décor
Disclaimer: c’est la première fois que je m’aide d’une IA pour rédiger un article, soyez indulgents.
Vous avez un PC, une carte graphique qui n’est pas illimitée (comme moi une RTX3060 en attendant de trouver une RTX3090 24 Gb VRAM, compliqué par les temps qui courent…) et des documents que vous préférez garder chez vous, pour un RAG., idéalement L’idée est séduisante : installer un modèle de langage, lui poser des questions sur ces fichiers et, pourquoi pas, en faire plus tard un assistant de travail. Le premier soir, tout semble simple. Un modèle se télécharge, l’interface s’ouvre et une réponse apparaît. Puis on colle un long document. La réponse tarde. On augmente le contexte. La mémoire déborde. On essaie un modèle plus gros : il démarre, mais répond à la vitesse d’un vieux modem. Voilà le moment où la petite démonstration devient un vrai projet.
Pour garder le fil, nous allons prendre pour référence ma machine tout au long de l’article, avec des projections sur différentes RTX, Gen 3/4/5. Au départ, elle dispose de 8 Go de mémoire graphique. Elle doit répondre en français et travailler sur des documents professionnels. Ce n’est qu’un exemple, pas une configuration recommandée à tout le monde. Lorsque nous passerons à 16 ou 24 Go, nous verrons ce qui change réellement, au lieu de supposer qu’une carte plus grosse règle tout.
J’ai organisé ce guide dans l’ordre où les questions se présentent dans la pratique. D’abord, comprendre la réponse qui s’affiche à l’écran. Ensuite, comprendre ce qui occupe la mémoire. À partir de là, choisir un modèle et un moteur d’inférence devient beaucoup moins mystérieux. Puis viendront les usages : code, recherche dans des documents, outils, sécurité et exploitation. Vous pouvez lire le tout d’une traite ou revenir à un chapitre au moment où votre projet en a besoin.
Chapitre 1 — La réponse se construit sous vos yeux
Une question en input , un token en output
Commençons par la scène la plus banale : vous écrivez « Résume-moi ce dossier en cinq points ». L’interface donne l’impression que le modèle lit, réfléchit et rédige. Techniquement, il reçoit une suite de tokens, calcule des scores pour les suites possibles, choisit un token et recommence. Une réponse de plusieurs phrases est donc le résultat d’une longue série de petits choix successifs.
Un token n’est pas forcément un mot. Selon le tokenizer, « documentation » peut être un seul élément ou plusieurs fragments. La ponctuation, les espaces, les nombres et le code suivent eux aussi des règles de découpage. C’est pour cela qu’un document de 4 000 mots n’occupe pas toujours le même nombre de tokens d’un modèle à l’autre. Dès qu’on parle de longueur de contexte, de vitesse ou de prix en calcul, c’est cette unité qu’il faut regarder.
Imaginez le modèle au moment où il a déjà produit « La mémoire graphique contient ». Il ne possède pas à l’avance la fin de la phrase. Il évalue les suites possibles à partir du texte reçu et de celui qu’il vient de générer. Ses poids représentent des régularités apprises pendant l’entraînement ; ils ne sont pas une base de données qu’il consulte mot à mot. Le contexte lui fournit, lui, les éléments utiles à la demande présente. Cette distinction entre poids et contexte évite bien des malentendus.
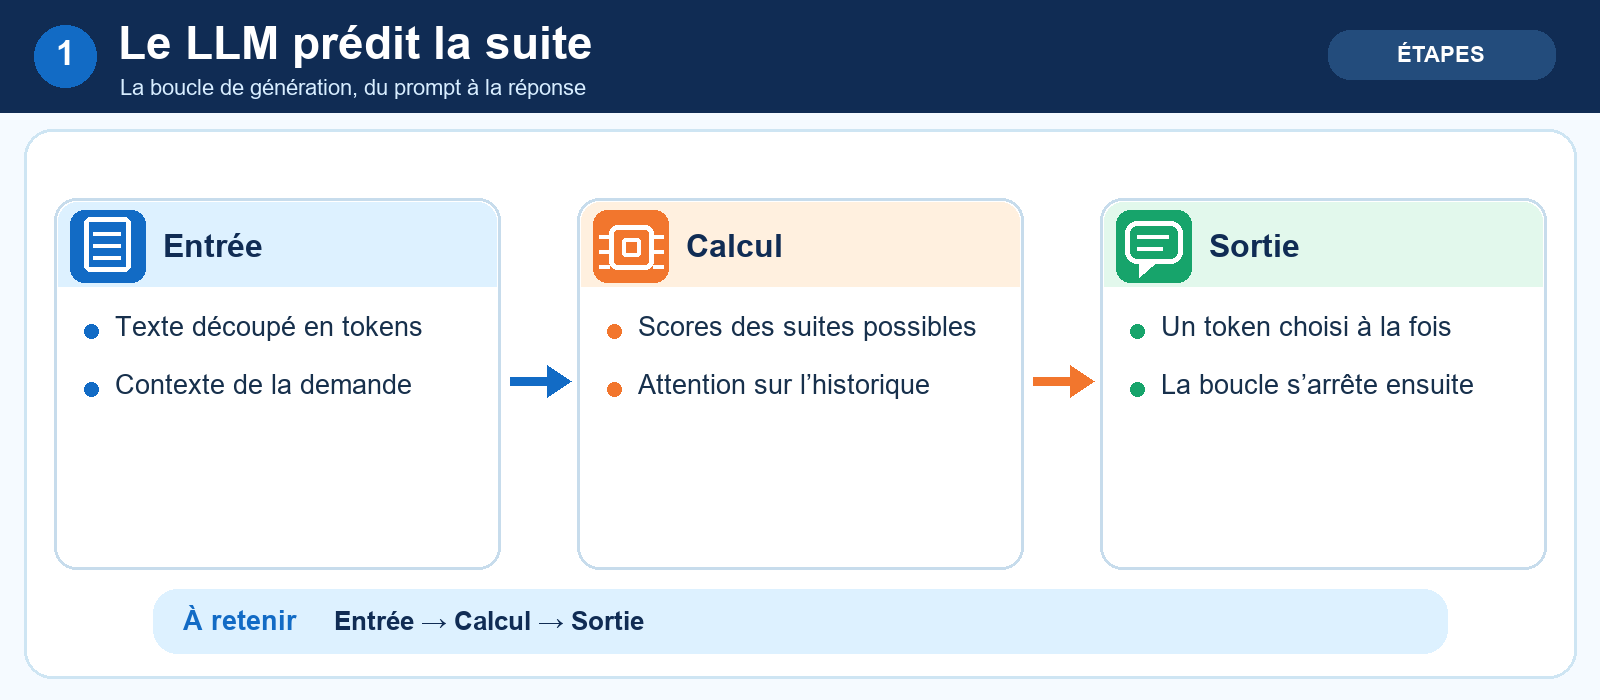
La boucle est simple à décrire, mais elle explique une grande partie de l’expérience utilisateur. Le système doit d’abord traiter l’entrée, puis produire une suite de tokens. Si rien n’apparaît pendant plusieurs secondes avant la première syllabe, on ne diagnostique pas le même problème que lorsqu’une réponse déjà commencée s’écoule très lentement. Nous reviendrons sur cette différence entre préremplissage et décodage.
Le tokenizer change la facture
Sur ma machine, nous voulons interroger des notes de réunion, parfois en français, parfois pleines de noms de produits ou de morceaux de code. Un compteur de mots ne suffit pas pour estimer le travail demandé au modèle. Les tokenizers découpent différemment les langues, les espaces, les séquences rares et les caractères spéciaux. Un long tableau collé dans le prompt peut réserver bien plus de contexte qu’on ne le pensait.
Le plus sûr est de mesurer quelques exemples de vos propres documents avec le tokenizer du modèle retenu. Faites le test sur un courriel court, une page de PDF extraite, un fragment de code et une conversation comportant plusieurs tours. Vous verrez aussitôt pourquoi une limite annoncée à 32 000 tokens n’équivaut pas à un nombre fixe de pages. La mise en forme, les consignes cachées de l’application et l’historique consomment aussi leur part.
Pour vous faire une idée, prenez une phrase française ordinaire, un montant écrit avec des décimales et une ligne de commande. La première peut se découper assez naturellement ; le montant et les signes de la commande produiront souvent davantage de fragments. Répétez l’essai avec des noms de clients, des acronymes maison et quelques mots anglais. Dans un corpus professionnel, ces détails pèsent sur la taille réelle d’un prompt. Ils expliquent aussi pourquoi deux modèles qui annoncent la même fenêtre de contexte n’accueillent pas toujours le même nombre de pages de vos dossiers.
Le vocabulaire du tokenizer est appris ou défini avec le modèle. On ne gagne rien à remplacer celui-ci par un autre pour grappiller quelques tokens : les identifiants ne correspondraient plus aux poids entraînés. Pour comparer deux modèles, notez donc la taille réelle de l’entrée pour chacun, puis mesurez le temps de traitement. Les « tokens par seconde » deviennent moins trompeurs quand on sait ce qui a été compté.
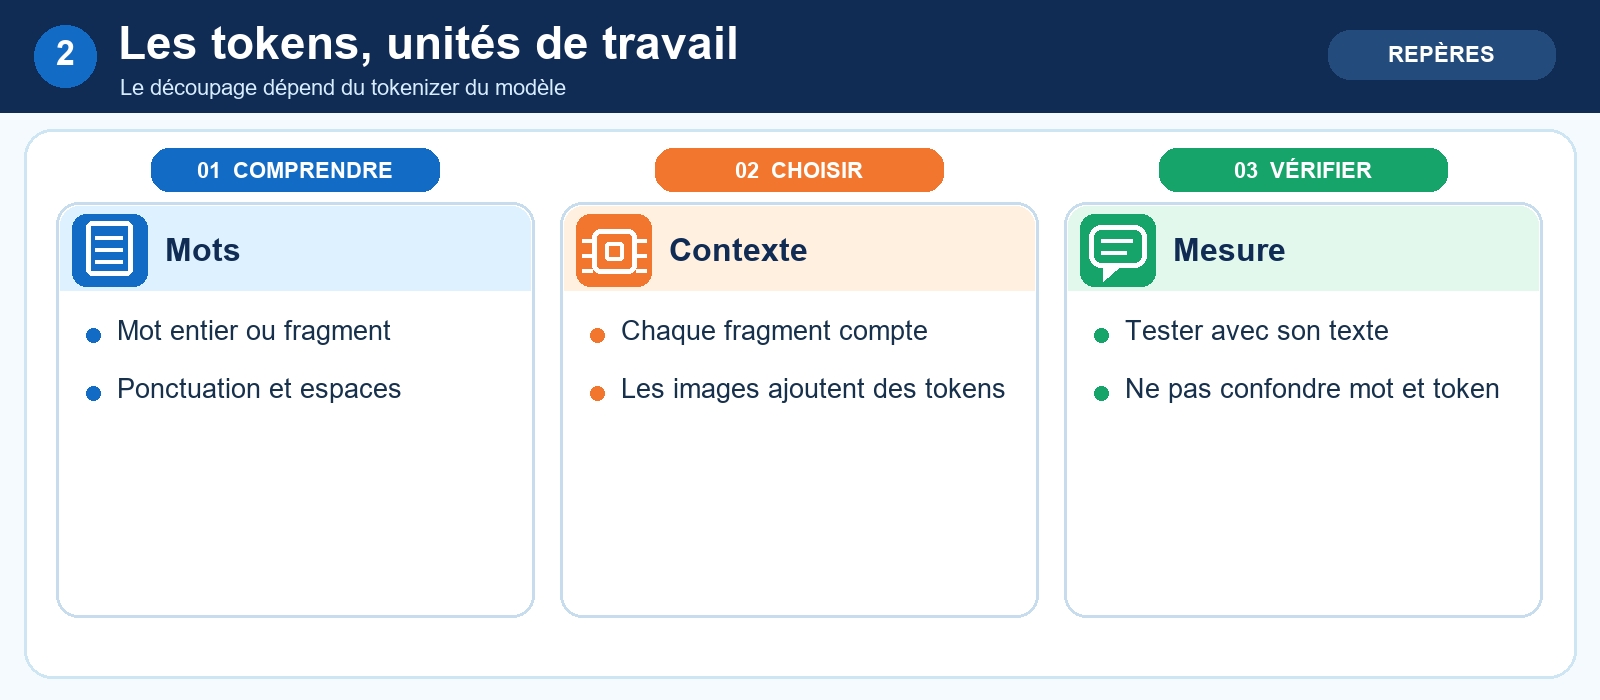
Il faut également distinguer la fenêtre de contexte maximale de la longueur confortable. Un modèle peut annoncer une très grande fenêtre et devenir lent, coûteux en mémoire ou moins fiable sur certains détails lorsque vous vous en approchez. Le bon réglage n’est donc pas « le maximum disponible », mais la longueur nécessaire à vos demandes habituelles, mesurée avec des documents représentatifs.
Le Transformer, sans cours de maths
Une fois les tokens découpés, ils passent dans le Transformer. Chaque identifiant est converti en représentation numérique. Les informations de position aident le modèle à distinguer l’ordre des éléments ; l’attention relie un token aux autres éléments pertinents du contexte ; d’autres blocs transforment la représentation au fil des couches. À la sortie, le modèle obtient des scores pour les prochains tokens possibles.
Les architectures modernes varient. Certaines utilisent des formes d’attention plus économes, d’autres mélangent plusieurs types de couches. Il n’est pas nécessaire de mémoriser chaque variante pour choisir un modèle local. Retenez surtout que le nombre de paramètres ne raconte pas toute l’histoire. Deux modèles de taille voisine peuvent exiger des quantités de mémoire très différentes lorsqu’on leur donne une longue conversation.
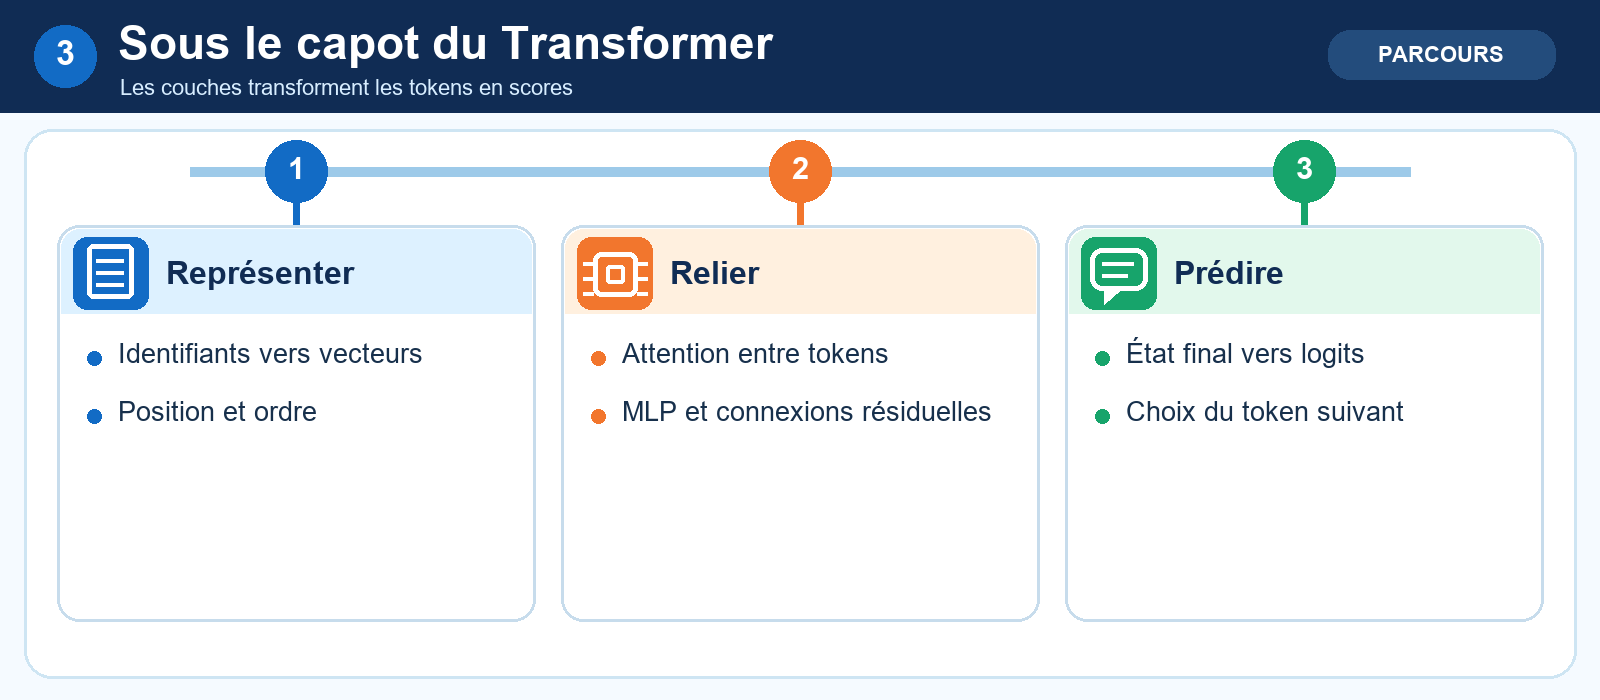
L’attention est souvent présentée comme la capacité du modèle à « regarder » les mots importants. L’image est utile à condition de ne pas la prendre au pied de la lettre. Il s’agit de calculs sur des représentations numériques. Les variantes MHA, MQA et GQA déterminent notamment combien d’états de clés et de valeurs doivent être conservés. Avec GQA, plusieurs têtes de requête partagent des têtes clé/valeur : sur certains modèles, cela allège fortement la mémoire du contexte. Vérifiez donc l’architecture réelle, pas seulement l’étiquette « 9B » ou « 14B ».
Un exemple rend l’idée plus concrète. Vous demandez « Quel délai s’applique à cette procédure ? » et le document contient plusieurs délais, chacun lié à une catégorie de demande. Le modèle doit relier votre question, la bonne catégorie et le passage qui donne la durée. Ce rapprochement n’est pas une recherche parfaite dans un tableau : il dépend de la façon dont la séquence est représentée et des informations disponibles dans le contexte. Si l’application a retiré la catégorie du passage ou si l’extraction du PDF l’a séparée du délai, même une bonne attention ne reconstituera pas ce qui manque.
Des noyaux de calcul optimisés rendent cette étape plus rapide et plus économe en mémoire, mais leur disponibilité dépend du moteur et du matériel. C’est l’une des raisons pour lesquelles une même carte peut se comporter différemment avec deux logiciels. Ne confondez pas la capacité théorique de l’architecture avec la performance de la pile que vous avez réellement installée.
Le cache KV, ce petit détail qui remplit la carte en VRAM
À chaque token généré, le modèle s’appuie sur le contexte déjà traité. Refaire tous les calculs depuis le premier message à chaque nouveau token serait pénalisant. Le moteur conserve donc, pour les tokens précédents, des états de clé et de valeur. C’est le cache KV. Vous pouvez le voir comme une mémoire de travail liée à la conversation en cours, distincte des poids du modèle.
Ce cache grossit avec le nombre de tokens actifs. Sa taille dépend également du nombre de couches, de l’architecture d’attention, de la précision choisie et du nombre de conversations traitées simultanément. C’est la raison pour laquelle un modèle peut démarrer sans difficulté sur un prompt court puis saturer la VRAM dès qu’on lui confie un long historique. Les poids n’ont pas changé. La mémoire de travail, elle, a augmenté.
Pour raisonner sans calculatrice spécialisée, retenez les facteurs : nombre de tokens, nombre de couches, nombre de têtes clé/valeur, dimension de ces têtes et précision des valeurs conservées. Il y a deux ensembles à stocker, les clés et les valeurs. Selon l’architecture, la pente peut être très différente. Les anciens modèles à attention multi-têtes complète coûtent souvent plus cher en cache que les modèles qui partagent leurs têtes KV. C’est pour cela que je me méfie d’une règle universelle du type « un token vaut tant de mégaoctets ».
Notre assistant documentaire ouvre une conversation, lit un dossier, puis reçoit trois questions complémentaires. L’historique de chaque tour reste utile tant qu’il appartient au contexte actif. Si l’interface garde tout sans limite, le cache continue de grandir. Il est parfois plus judicieux de résumer un échange ancien, de rouvrir une conversation ou de rappeler seulement les décisions qui comptent. On économise de la mémoire et on évite de distraire le modèle avec des détails obsolètes.
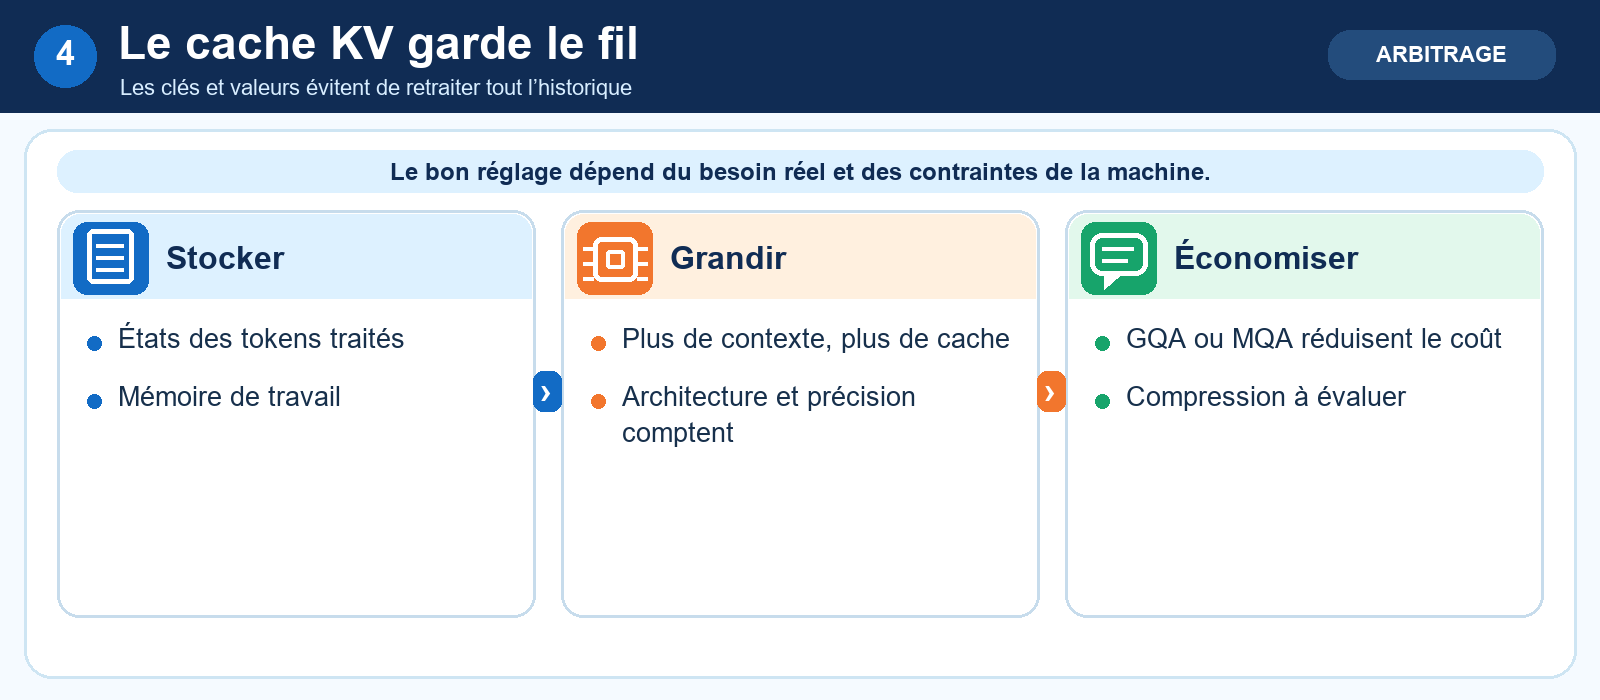
Certaines implémentations compressent le cache. C’est utile, mais ce réglage ne doit pas être activé au hasard sur un travail exigeant. Une discussion générale tolère peut-être une approximation qu’un appel d’outil, une sortie JSON, un calcul ou la citation d’un passage précis ne tolérera pas. Comparez les réponses sur vos cas réels avant de sacrifier de la précision pour économiser quelques gigaoctets.
Pourquoi la première réponse tarde parfois
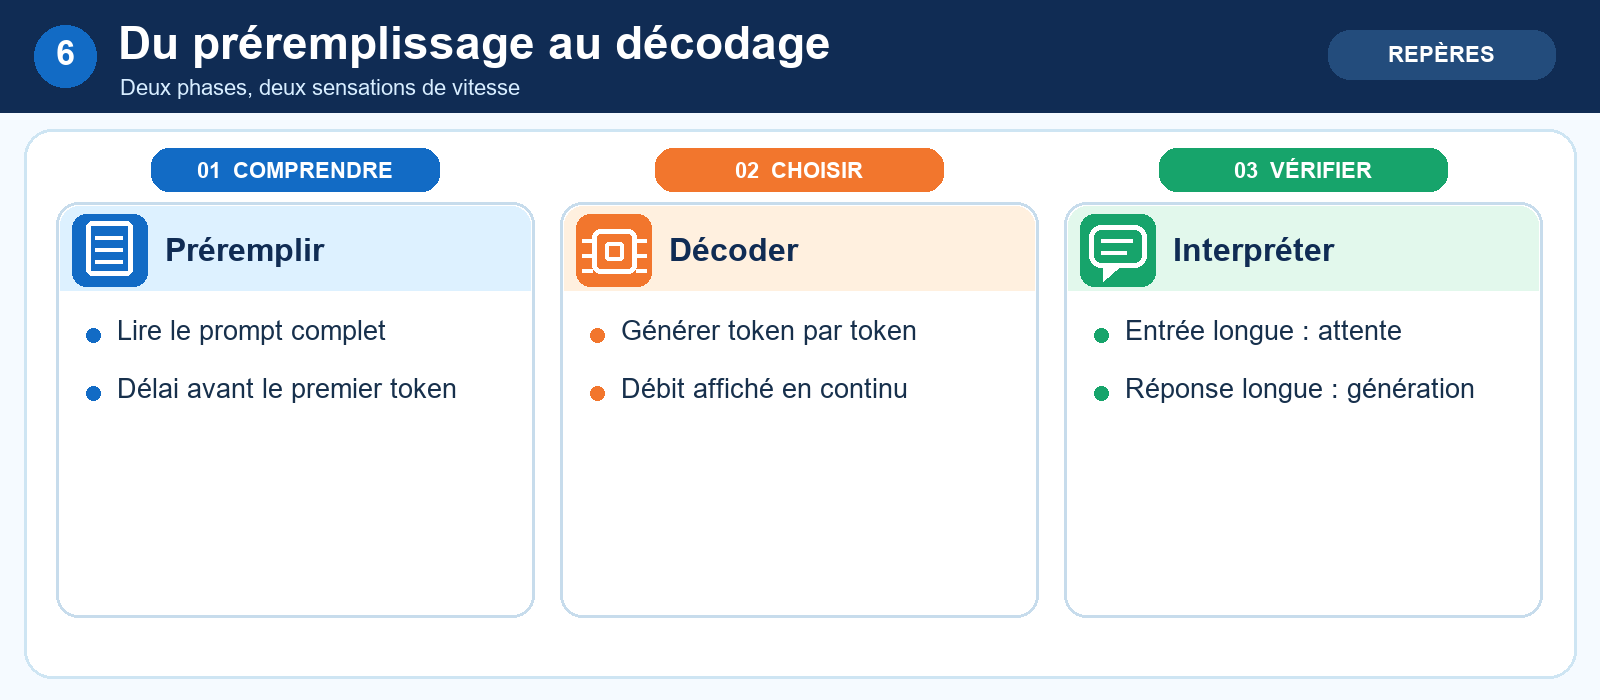
Le modèle traverse deux phases. Pendant le préremplissage, il traite les tokens que vous lui avez envoyés : consigne, question, historique et documents. Cette phase explique une grande partie du délai avant l’apparition du premier token. Pendant le décodage, il génère la réponse un token après l’autre. C’est la vitesse du texte qui s’affiche progressivement.
Prenons notre dossier professionnel. Si vous collez vingt pages en une fois, le préremplissage peut devenir sensible, même si vous demandez une réponse de trois lignes. À l’inverse, une question courte suivie d’un long rapport sollicite surtout le décodage. Dans une conversation qui s’étire, les deux coûts finissent par se cumuler. Voilà pourquoi il faut mesurer séparément le temps jusqu’au premier token et le débit de génération.
Faites une expérience très simple. Envoyez d’abord une question de deux lignes et demandez une réponse de deux lignes. Gardez le même modèle, mais remplacez l’entrée par un long document tout en conservant la même réponse courte : la différence observée concerne surtout le traitement initial. Revenez ensuite à la petite question et demandez une réponse de plusieurs pages : vous regardez cette fois la génération. Les mesures ne seront pas parfaites, mais elles donnent immédiatement un vocabulaire pour parler des lenteurs au lieu de dire seulement « c’est lent ».
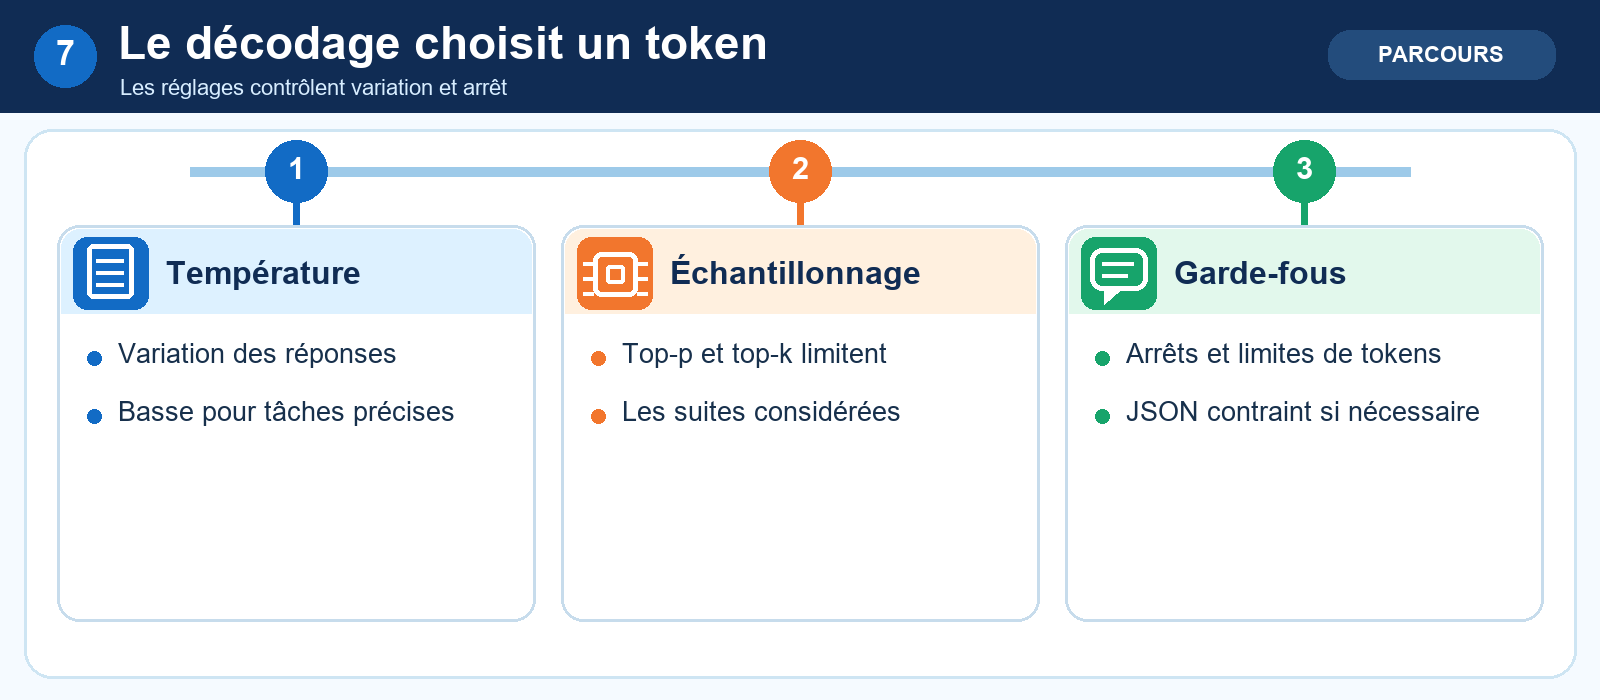
Les réglages de décodage influencent le style et la régularité. Une température basse favorise des réponses plus stables. Un échantillonnage plus ouvert peut aider à chercher des idées. Les limites de longueur, les tokens d’arrêt et les contraintes de format évitent les sorties interminables ou invalides. Pour une extraction de données ou un correctif de code, je commencerais avec des réglages prudents et une vérification automatique du résultat. Pour un brainstorming, on peut laisser davantage de latitude.
La température n’est pas un bouton « vérité ». La baisser réduit la variation ; elle ne corrige ni un document manquant, ni une consigne ambiguë. Top-p ou top-k limitent l’ensemble dans lequel le prochain token peut être choisi. Une pénalité de répétition peut aider si le modèle tourne en rond, mais un réglage trop fort déforme parfois les réponses. Il vaut mieux partir de valeurs conseillées par le modèle ou le moteur, puis changer un seul paramètre et comparer sur le même petit jeu de prompts.
Pour un format strict, le vrai filet de sécurité se trouve aussi dans l’application. Définissez le schéma attendu, vérifiez les champs reçus et refusez une sortie invalide au lieu de deviner ce que le modèle « voulait dire ». Si le modèle doit appeler un outil, même principe : des arguments bien formés ne suffisent pas ; le logiciel doit encore vérifier que l’action est autorisée.
Le modèle n’est pas seulement un fichier de poids
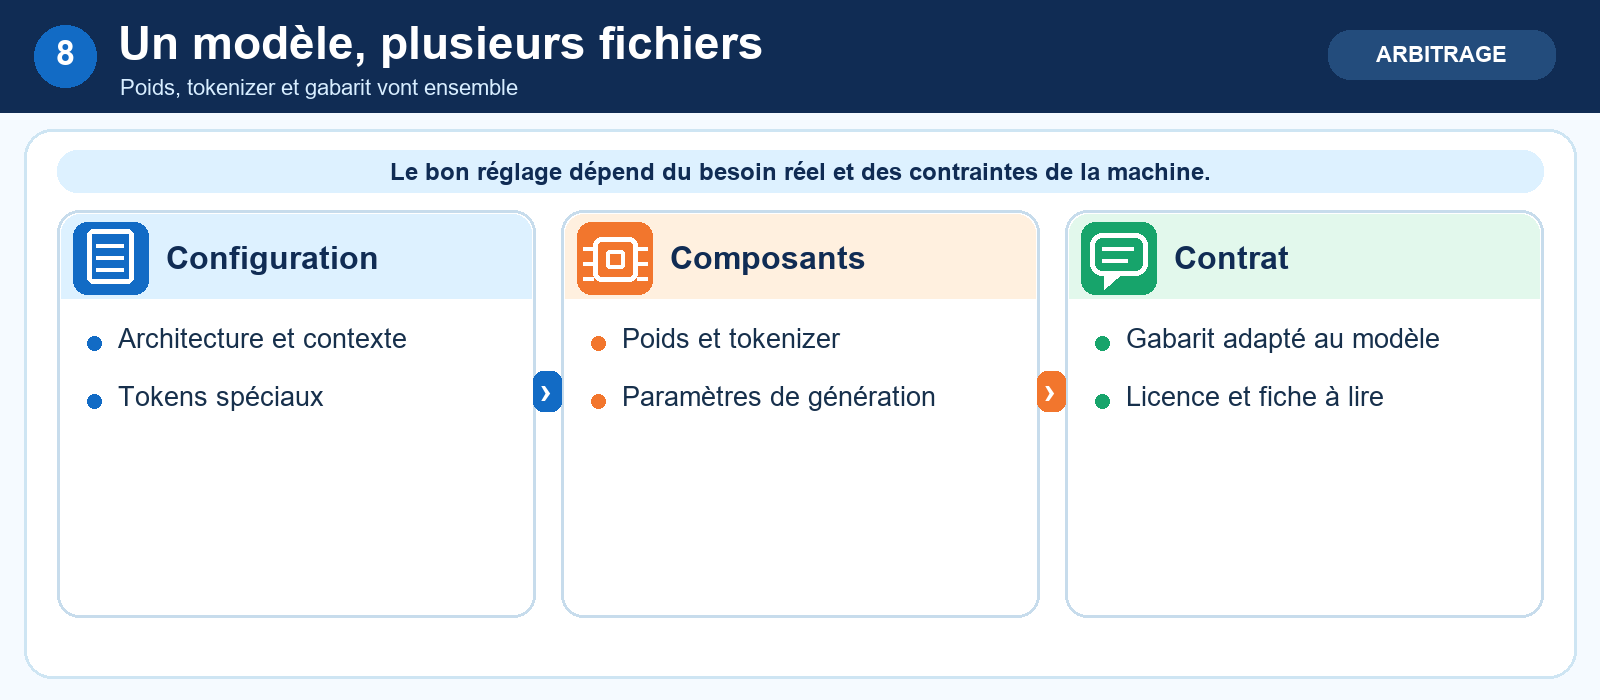
Télécharger les poids ne suffit pas toujours. Le modèle arrive avec une configuration, un tokenizer, parfois un processeur d’images, des tokens spéciaux, un gabarit de conversation, des réglages de génération et une licence. Le gabarit indique au modèle où commencent les messages système, utilisateur, assistant et outil. Utiliser celui d’un autre modèle peut produire des réponses incohérentes ou fausser entièrement une comparaison.
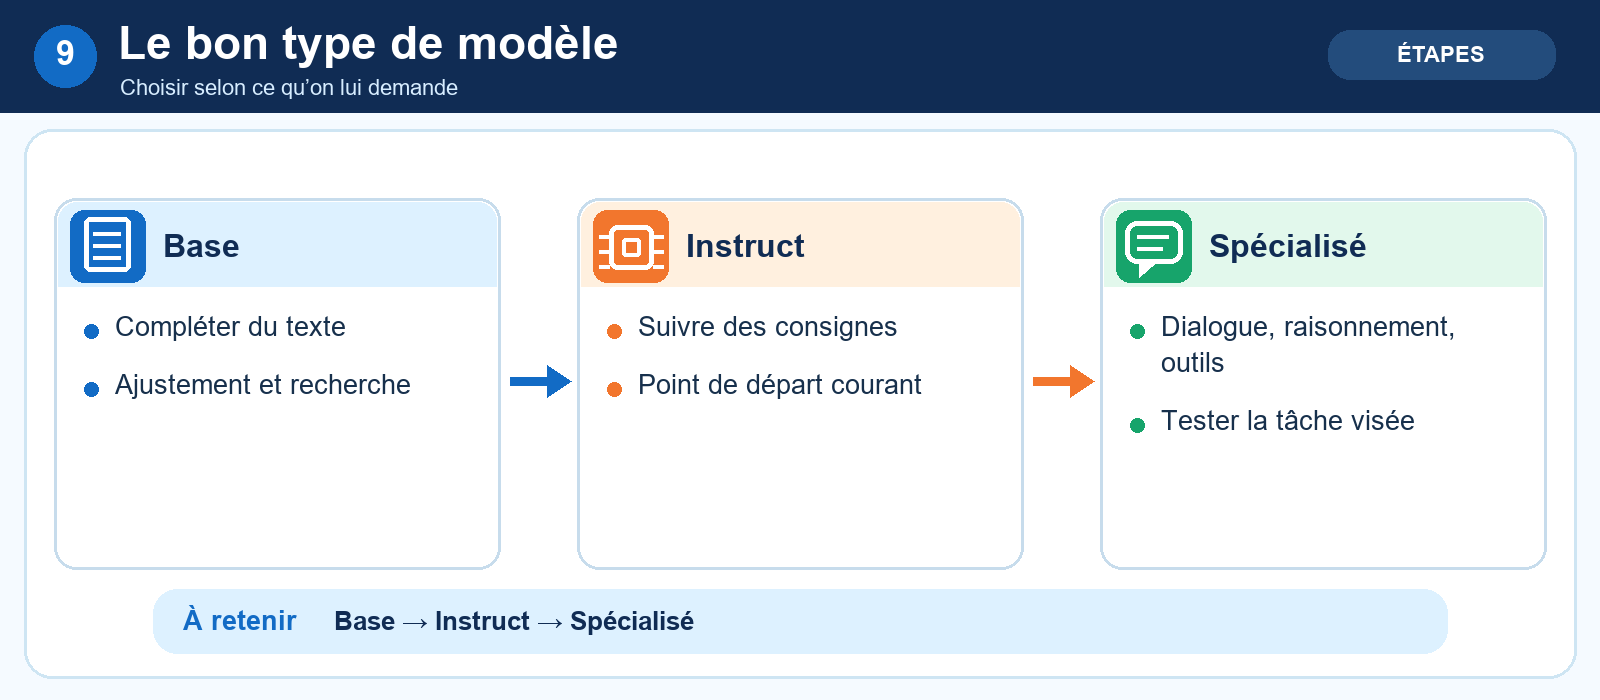
Avant de conclure qu’un modèle est mauvais, vérifiez donc une chose très terre à terre : l’application lui parle-t-elle dans le format attendu ? Un modèle de base complète volontiers du texte ; un modèle instruct suit plus volontiers une consigne ; un modèle spécialisé pour les outils attend parfois un schéma strict. Choisissez la bonne variante et gardez son tokenizer et son gabarit ensemble. Ce sont des pièces du même ensemble.
Le problème se voit facilement quand une application permet de changer de modèle en un clic. Si elle continue d’envoyer exactement les mêmes marqueurs de rôle à tous les candidats, une partie de la comparaison devient injuste. Le premier peut recevoir le format qu’il attend, le second un mélange de balises inconnues. Une réponse confuse n’indique alors pas nécessairement une faiblesse du second modèle. Traitez le gabarit comme un contrat d’interface : il change avec le modèle et doit être vérifié au même titre que les poids.
Lisez également la distinction entre variante de base, instruct, conversation, raisonnement et utilisation d’outils. Certaines variantes produisent des tokens supplémentaires avant la réponse finale ; d’autres optimisent surtout la syntaxe des appels structurés. Prenez celle qui correspond au travail demandé. Un modèle de base peut être excellent pour la recherche et exaspérant comme assistant de bureau ; ce n’est pas une contradiction, c’est une question d’usage.
Au terme de ce premier chapitre, notre machine n’est plus une boîte noire. Nous savons ce qu’elle reçoit, ce qu’elle conserve et pourquoi la réponse arrive en deux temps. Nous pouvons maintenant regarder la mémoire sans nous perdre dans les fiches commerciales.
Chapitre 2 — Faire tenir le projet dans la machine
Ce que « local » change vraiment
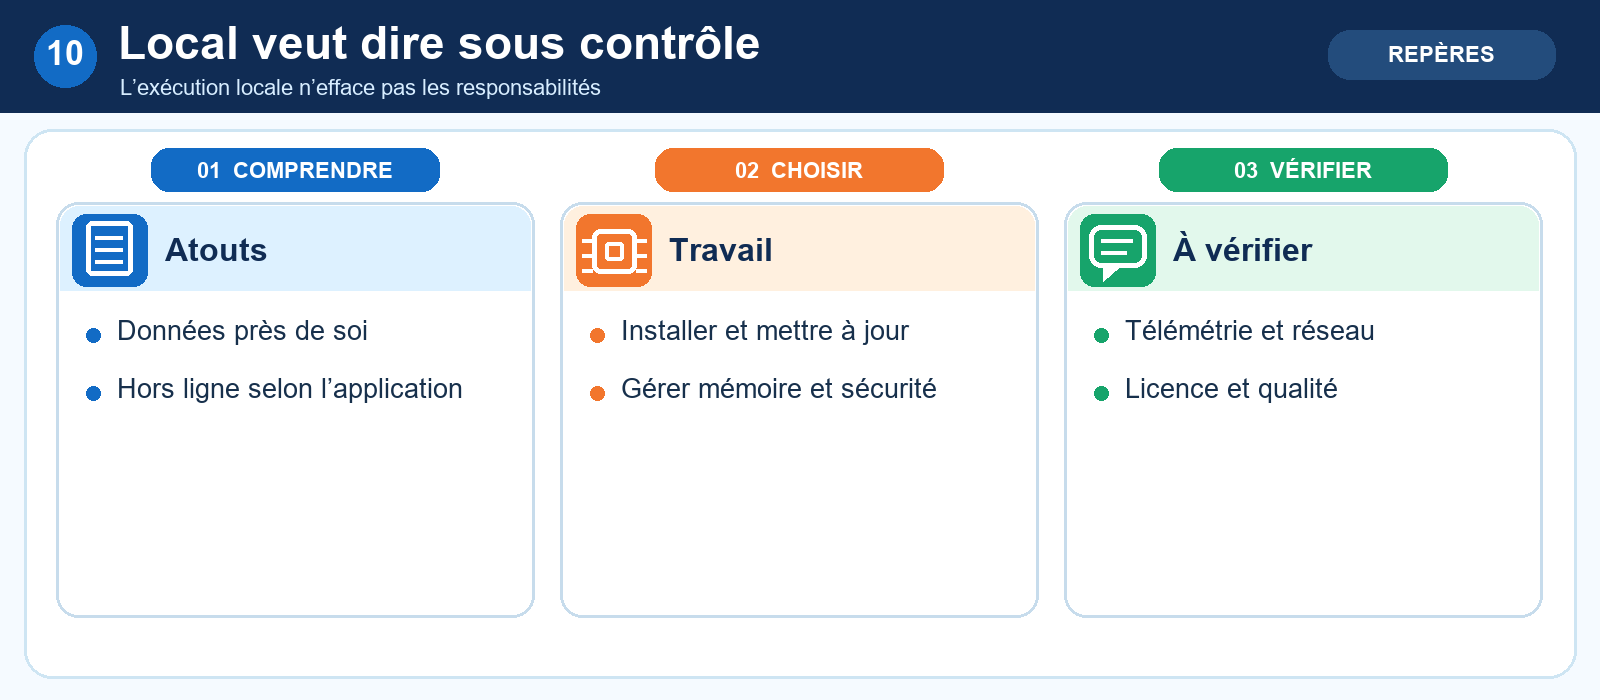
Faire tourner un LLM en local signifie que vous choisissez les poids et le logiciel qui les exécute sur une machine sous votre contrôle. Cela peut être un portable, un PC de bureau, un petit serveur ou une infrastructure privée. Le modèle peut même fonctionner sans connexion, si l’application et ses dépendances le permettent. En revanche, « local » ne dit à lui seul ni que l’outil est sûr, ni que les données ne sortent jamais, ni que la licence autorise tous les usages.
Ce choix donne une liberté appréciable : on peut comparer plusieurs modèles, régler le contexte, conserver les documents près de soi et construire une application qui répond à un besoin précis. En échange, il faut gérer les mises à jour, la mémoire, les performances, la sécurité et les sauvegardes. Pour un projet individuel, cela peut rester simple. Pour un service utilisé par plusieurs personnes, c’est déjà une petite exploitation informatique.
Il y a plusieurs façons d’être « local ». Un modèle peut tourner entièrement sur le PC, une API peut être servie sur une station de travail du réseau interne, ou un serveur privé peut héberger des modèles pour une équipe. Dans les trois cas, le périmètre et les obligations diffèrent. Sur un portable isolé, on surveille surtout les fichiers et les connexions de l’application. Sur un serveur partagé, on doit ajouter l’authentification, la supervision, la séparation des usages et la politique de conservation des traces. Le mot « local » ne choisit pas l’architecture à votre place.
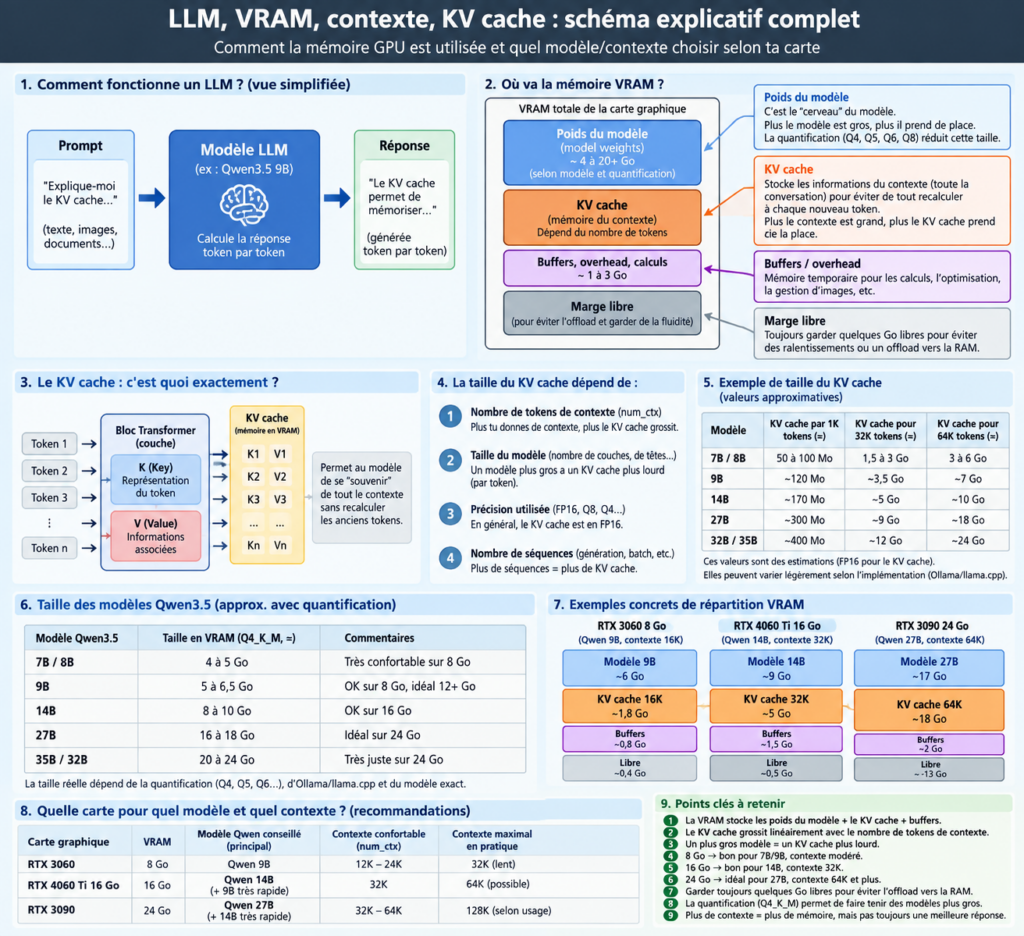
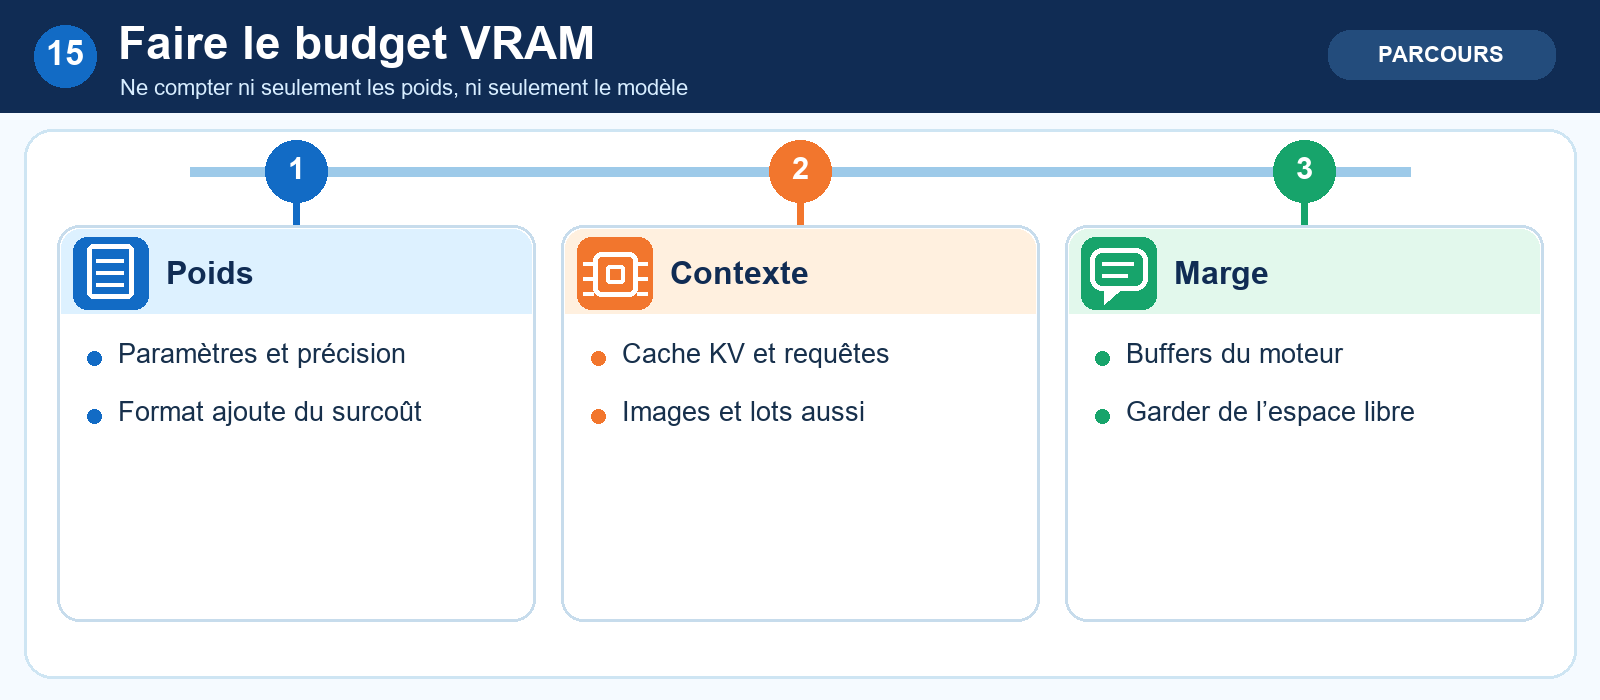
Mon PC de départ dispose de 8 Go de VRAM. Je précise un peu: Windows 11: AMD 5 5600x – 64 Gb RAM DDR4, nvMe en stockage, ollama et openweb-bui en docker. Il serait tentant de chercher « le plus gros modèle qui rentre ». Je préfère poser la question autrement : quel modèle produit des réponses suffisamment bonnes, avec le contexte dont j’ai besoin, sans rendre chaque échange pénible ? Le modèle doit laisser de la place au cache KV, aux buffers du moteur, à d’éventuelles images et à une marge de fonctionnement. La taille du fichier sur le disque ne répond pas à cette question.
La VRAM a quatre occupants
Pensez à la mémoire graphique comme à une pièce déjà meublée. Les poids du modèle prennent une première place. Le cache KV s’étend à mesure que la conversation grandit. Le moteur réserve aussi des buffers et de l’espace temporaire pour ses calculs. Enfin, une marge libre évite de finir au millimètre et de subir une erreur de mémoire dès que le prompt change un peu.
La formule utile est donc : mémoire nécessaire ≈ poids chargés + cache KV du contexte + surcoût du moteur + marge. Si plusieurs requêtes sont traitées en même temps, ajoutez leur coût. Avec un modèle multimodal, l’encodeur d’image et les représentations visuelles comptent également. Pour un mélange d’experts, ne confondez pas les paramètres actifs à un instant donné avec les poids totaux qu’il faut charger quelque part.
Faisons un budget fictif. Supposons qu’un modèle quantifié occupe un peu plus de 5 Go. Il reste, sur une carte de 8 Go, moins de 3 Go avant même de compter le cache et le moteur. Une conversation courte peut passer. Un historique prolongé, une image et un second utilisateur peuvent dépasser la limite. Si le logiciel commence à déplacer des couches vers la RAM, l’application peut encore fonctionner, mais le débit chute. Il faut donc mesurer le pic réel dans une situation représentative, puis garder une réserve plutôt que viser 100 % de remplissage.
La formule des poids seule donne un ordre de grandeur : nombre de paramètres multiplié par la quantité moyenne d’octets utilisée par paramètre. Une quantification à quatre bits suggère environ un demi-octet par valeur, mais les échelles, les métadonnées et certaines couches plus précises ajoutent du volume. Comparez cette estimation à la taille véritable du fichier chargé et à la consommation observée dans le moteur. Une valeur calculée sur un coin de table sert à éliminer les impossibilités, pas à promettre une configuration stable.
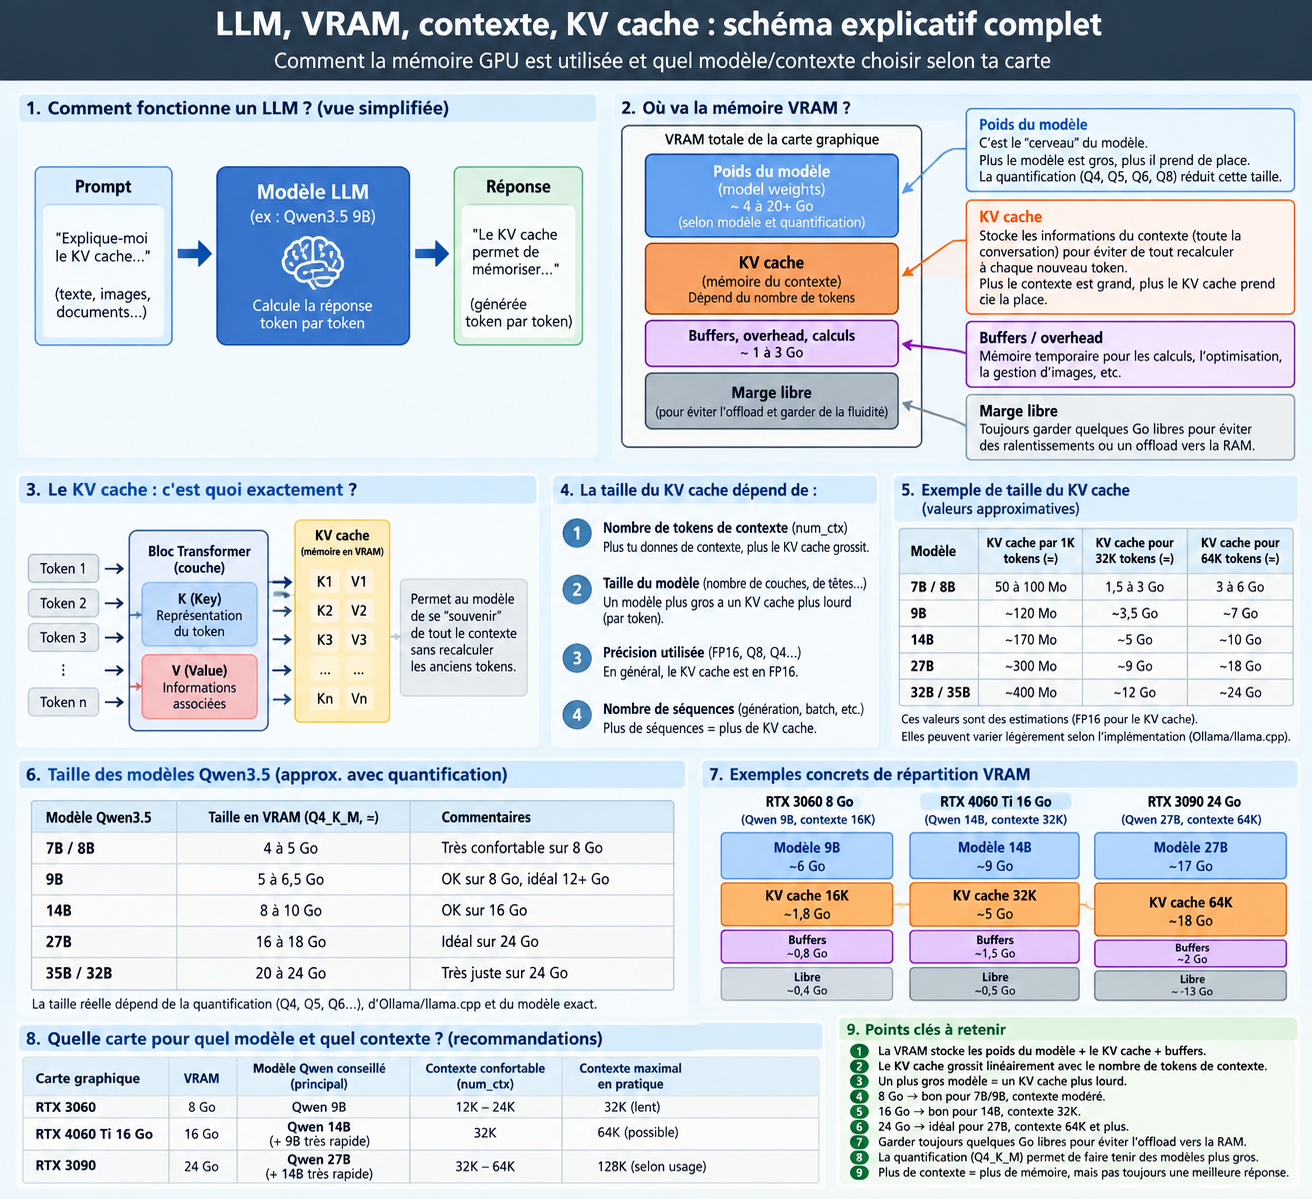
Cette première infographie rassemble les pièces du puzzle : modèle, cache, contexte et marge. Les tableaux chiffrés qui y figurent sont utiles pour se repérer, mais ils décrivent des scénarios approximatifs. Ils ne remplacent pas la mesure sur votre moteur, votre quantification et vos documents. C’est particulièrement vrai quand on passe de 16 000 à 64 000 tokens ou lorsqu’on ajoute plusieurs conversations en parallèle.
La quantification, ou l’art de gagner de la place
Les poids sont des nombres. La quantification les stocke avec moins de précision pour réduire leur empreinte mémoire. Un modèle en précision élevée peut donner une référence de qualité, mais occupe davantage de VRAM. Des formats intermédiaires comme Q5 ou Q4 peuvent offrir un bon équilibre. Descendre très bas permet parfois de charger un modèle plus grand, avec un risque accru sur les tâches qui demandent de la précision.
Le piège serait de transformer cette échelle en verdict universel. Q4 n’est pas automatiquement « le meilleur » ; Q8 n’est pas automatiquement nécessaire. La bonne réponse dépend du modèle, du format exact, du moteur et des tâches. Une conversation courante peut rester convaincante alors qu’une extraction structurée, un calcul ou un correctif de code se dégrade. Il faut tester les erreurs qui comptent pour vous, pas seulement lire une moyenne de benchmark.
Pour une première comparaison, gardez le même modèle et essayez deux niveaux de quantification que votre moteur prend correctement en charge. Soumettez-lui un document court dont vous connaissez les réponses, une question de code et une extraction en champs précis. Regardez surtout les différences concrètes : un montant oublié, une condition juridique inversée, une accolade manquante. Si les deux versions se comportent pareil sur vos cas, la plus légère peut être un choix raisonnable. Si l’une dérape sur une tâche essentielle, quelques centaines de mégaoctets gagnés ne valent pas forcément le risque.
Il faut aussi distinguer la quantification des poids de celle du cache KV. La première réduit principalement la taille du modèle chargé. La seconde touche la mémoire consommée par les tokens du contexte actif. Mélanger les deux mène vite à de fausses promesses de capacité. Un modèle qui tient sur la carte avec une question courte n’a pas prouvé qu’il tiendra avec une conversation de 32 000 tokens.
Formats et moteurs : choisir un couple compatible
Les modèles ne se présentent pas tous sous la même forme. Les fichiers safetensors sont courants dans l’écosystème des bibliothèques de modèles et évitent le comportement dangereux de la désérialisation fondée sur pickle. GGUF occupe une grande place dans les usages locaux avec llama.cpp et de nombreuses applications de bureau. D’autres formats existent pour des moteurs ou des méthodes de quantification spécifiques.
Pour démarrer, choisissez d’abord le mode d’utilisation : interface simple pour une personne, API locale pour une application, ou serveur privé pour plusieurs utilisateurs. Vérifiez ensuite que le moteur prend bien en charge l’architecture, le format des poids, le gabarit de conversation et la longueur de contexte visée. Une incompatibilité à l’un de ces niveaux peut faire perdre beaucoup de temps alors que les poids du modèle sont parfaitement corrects.
La prudence commence au téléchargement. Un fichier de poids issu d’une source inconnue ou accompagné de code qui s’exécute au chargement mérite le même regard qu’un autre logiciel trouvé au hasard. Vérifiez l’origine, les fichiers nécessaires, la licence et les éventuelles instructions d’exécution. Le fait qu’un fichier soit présenté comme un modèle ne lui confère aucune immunité. Sur une machine contenant des documents confidentiels, il est particulièrement important de comprendre quels composants seront exécutés et quels accès réseau ils auront.
Une interface de bureau aide à comparer rapidement les modèles. Un moteur en ligne de commande donne davantage de contrôle. Un serveur d’inférence devient pertinent si plusieurs personnes ou applications partagent le même modèle. Dans ce dernier cas, la question n’est plus seulement « est-ce que le modèle démarre ? ». Il faut aussi regarder le débit sous charge, les files d’attente, la mémoire par requête, la supervision et la reprise après incident.
8, 16 ou 24 Go : des repères, pas des promesses
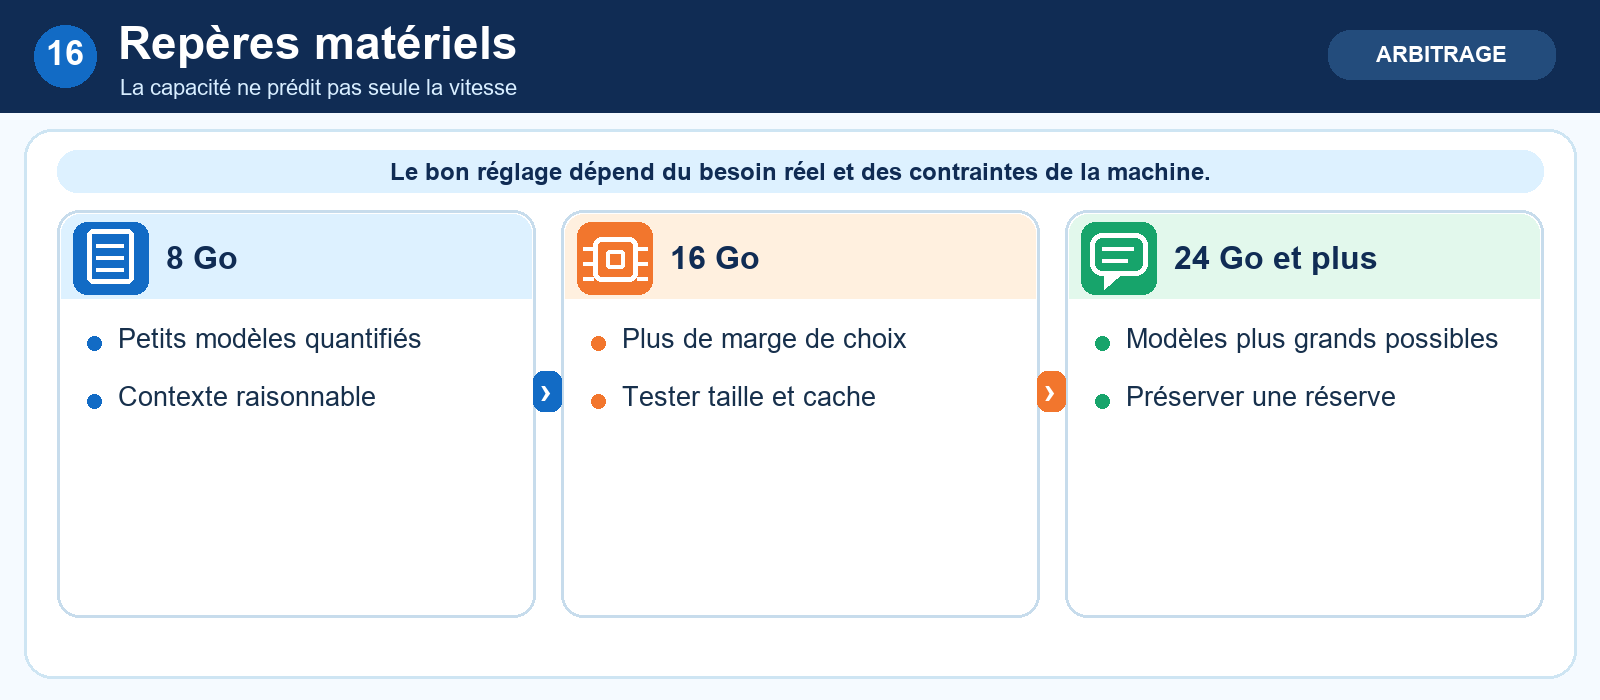
Revenons au choix concret. Avec 8 Go, un modèle instruct compact et bien quantifié est souvent plus agréable qu’un modèle plus gros qui déborde vers la RAM. Avec 16 Go, on peut essayer des modèles intermédiaires et un contexte plus confortable. À 24 Go, les options s’élargissent encore, mais un long historique, des images ou une forte concurrence peuvent toujours saturer la carte. Deux GPU de même capacité ne donnent d’ailleurs pas la même vitesse : leur bande passante et leur puissance de calcul comptent aussi.
Les deux guides Qwen fournis illustrent très bien le raisonnement à suivre : partir de la VRAM, choisir une longueur de contexte réaliste, puis ajuster la quantification. Leurs chemins « 8 Go → 9B », « 16 Go → 14B » et « 24 Go → 27B » sont des points de départ pour tester, pas des certifications de compatibilité. Un même 27B peut sembler confortable à 32 000 tokens et devenir difficile à servir à 64 000, selon son architecture et le moteur.
Le scénario 8 Go répond d’abord à une attente de fluidité : un chat, du code simple, un RAG léger et des documents de taille modérée. Le scénario 16 Go cherche un équilibre entre une réponse plus riche et un contexte courant autour de 32 000 tokens. À 24 Go, le modèle plus grand peut être séduisant pour le code, l’analyse et la vision, mais la marge redevient un sujet si l’on pousse à la fois la taille du modèle et celle du contexte. Dans les trois cas, le « meilleur » réglage est celui qui tient pendant une session normale, pas celui qui démarre une seule fois sur un prompt vide.
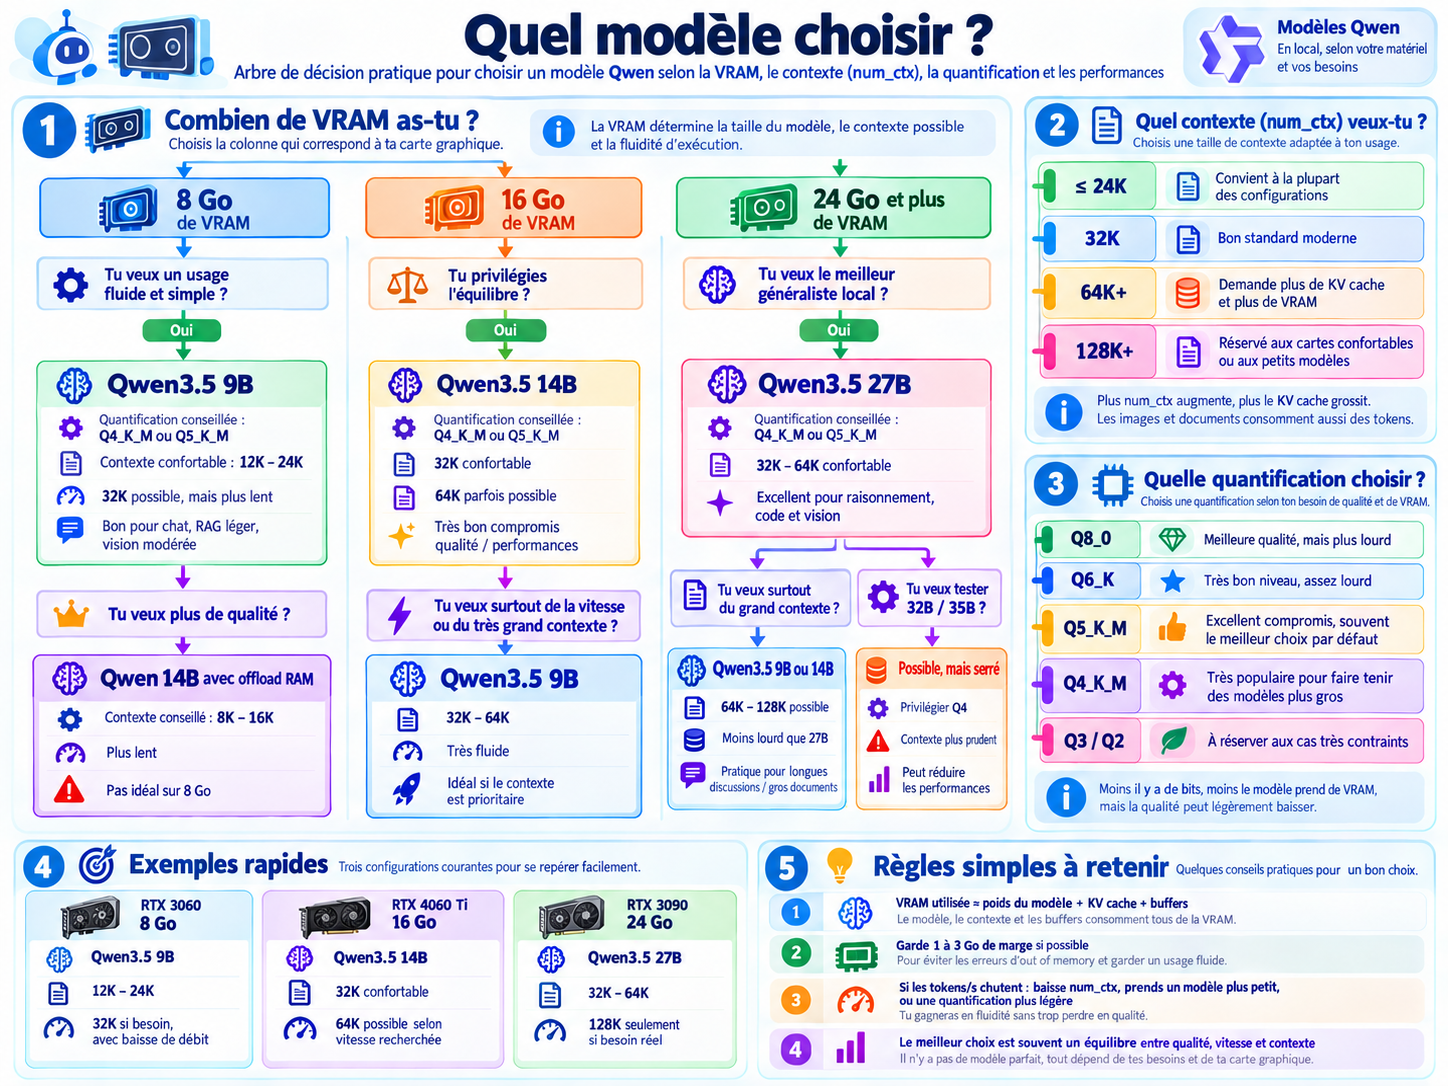
Dans ce premier arbre, prenez surtout le temps de suivre les embranchements. Si votre priorité est une conversation fluide avec quelques documents, vous ne ferez pas le même choix que si vous voulez un gros contexte ou un modèle plus habile en code. Les options de repli vers la RAM existent, mais elles peuvent coûter cher en temps de réponse.
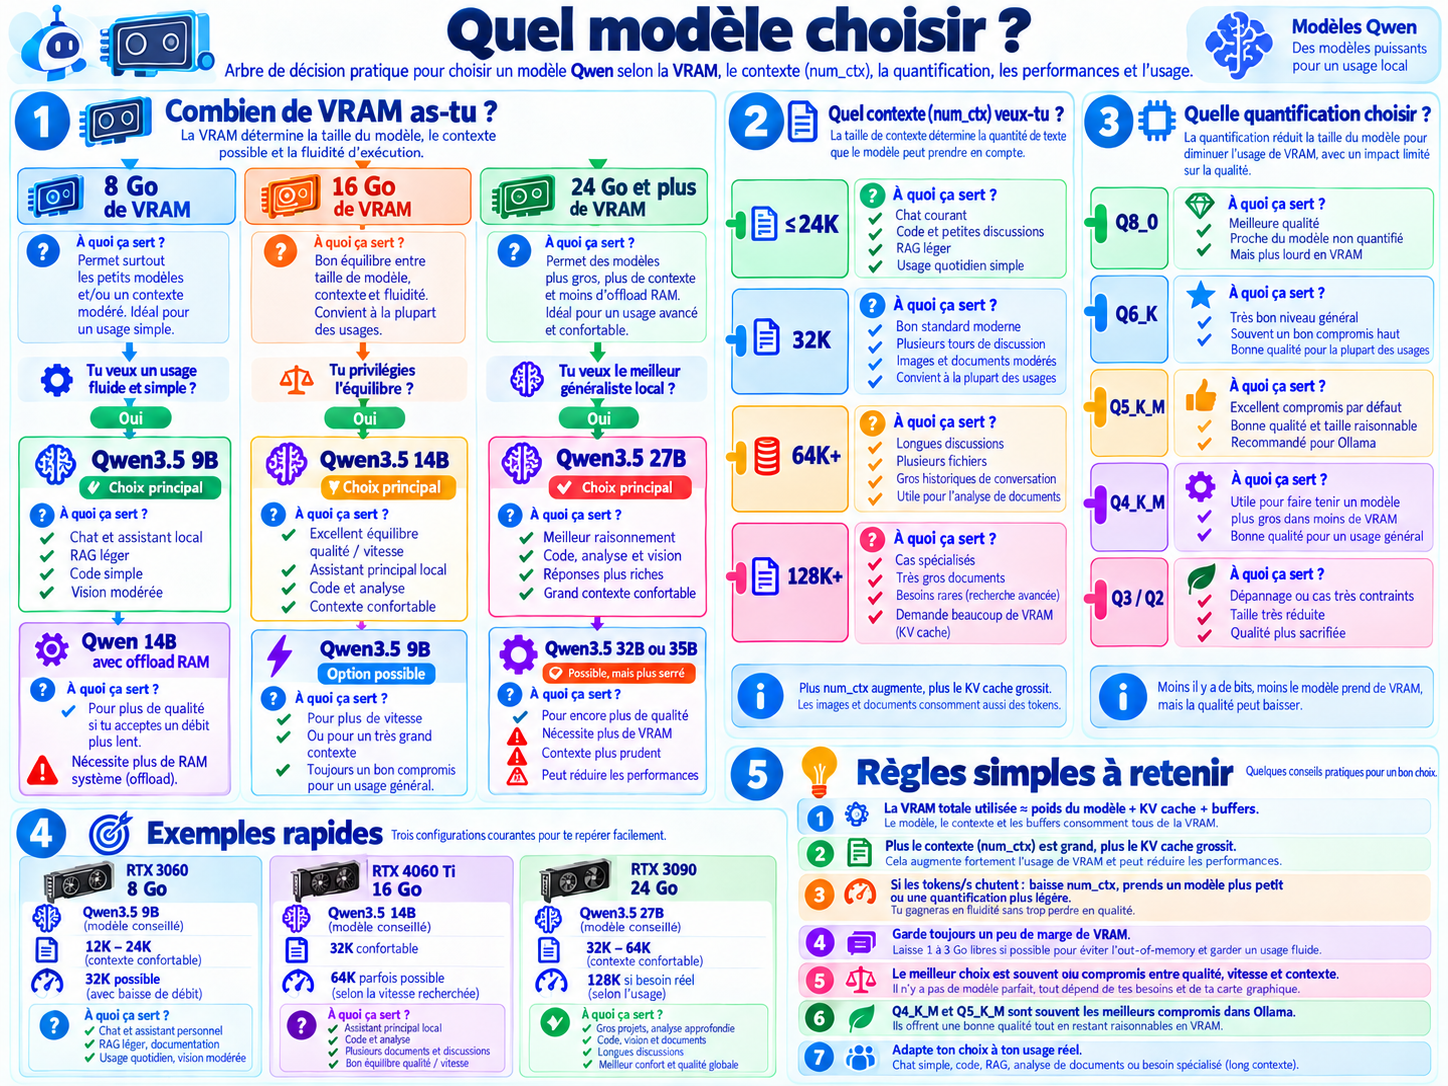
Le second arbre insiste sur un point souvent oublié : le contexte annoncé n’est pas un cadeau gratuit. À chaque palier, posez-vous la question « ai-je vraiment besoin de garder tout cela dans le prompt ? ». Une recherche ciblée dans les documents peut offrir une meilleure expérience qu’une immense fenêtre remplie de passages inutiles.
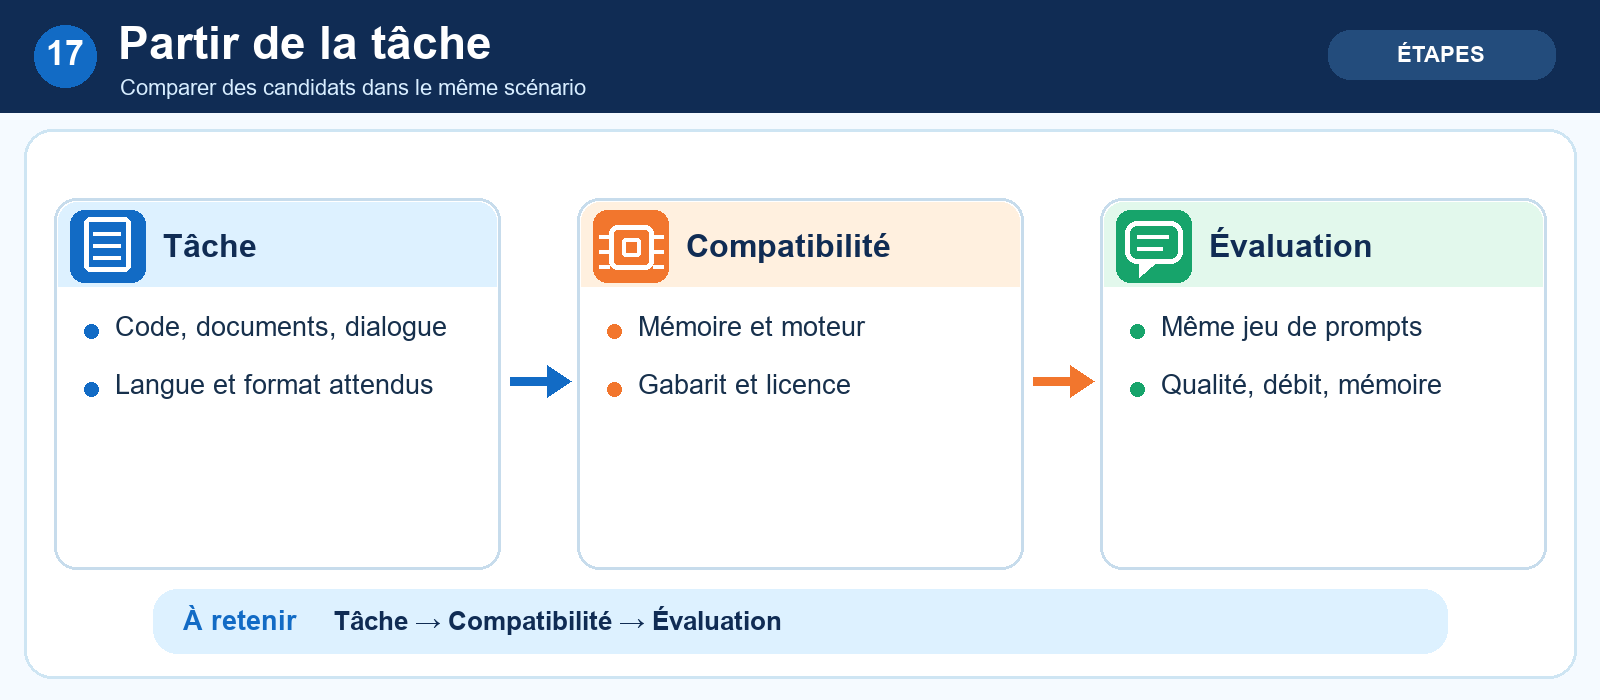
Pour rendre ces schémas opérationnels, je préparerais cinq demandes réelles : une conversation courte, une page technique, un dossier plus long, une réponse structurée et une tâche où une erreur se voit facilement. Je lancerais exactement les mêmes demandes avec deux ou trois candidats. Je noterais la qualité, le délai avant le premier token, le débit de la réponse et le pic de VRAM. C’est peu de travail comparé au temps perdu à installer dix modèles sans méthode.
La vitesse ne se résume pas aux tokens par seconde
Une carte qui a suffisamment de mémoire peut être lente si sa bande passante est faible, si une partie du modèle est déchargée vers le CPU, ou si le moteur exploite mal l’architecture choisie. Le préremplissage et le décodage n’utilisent pas le matériel de la même manière. Un tableau de « tokens par seconde » sans la taille du prompt, la longueur du contexte et le nombre d’utilisateurs donne donc une image incomplète.
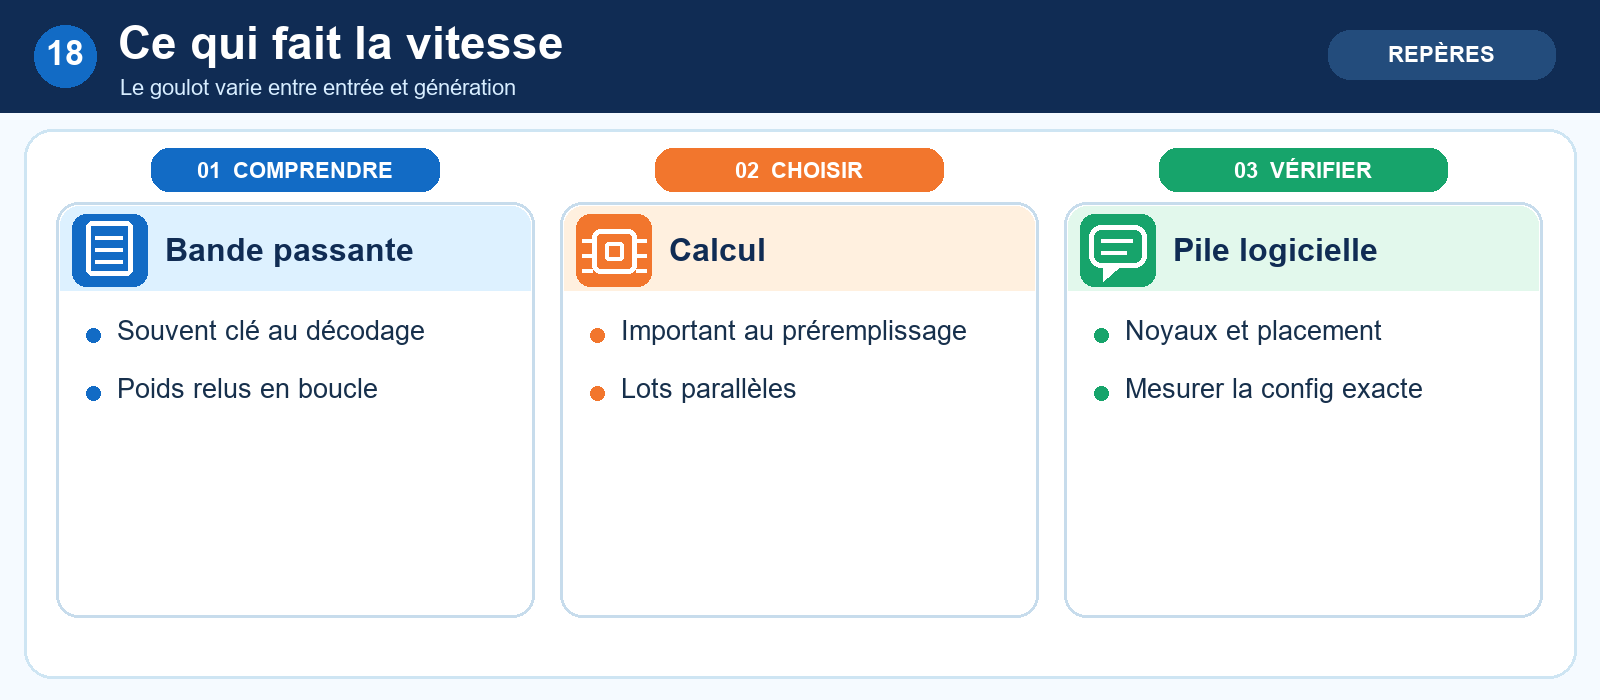
Le contexte long a lui aussi un prix. Il occupe davantage de cache, rallonge le traitement de l’entrée et peut diluer l’attention du modèle. Lorsque vous cherchez une information dans des centaines de documents, la bonne approche consiste souvent à retrouver les passages pertinents puis à les envoyer au modèle. Nous reviendrons sur ce principe avec le RAG. Si vous travaillez sur des images, souvenez-vous qu’elles sont converties en représentations qui consomment elles aussi du contexte et parfois de la mémoire supplémentaire.
Quelques habitudes aident immédiatement. Donnez des titres clairs aux passages, conservez leur origine et placez les consignes essentielles là où elles ne se perdent pas dans l’historique. Résumez les tours devenus secondaires au lieu de prolonger une conversation sans fin. Si une requête doit comparer plusieurs pièces, envoyez celles qui servent à la comparaison et demandez des citations vérifiables. Un contexte énorme rempli de bruit peut coûter plus cher et répondre moins bien qu’un contexte plus court et bien préparé.
La multimodalité demande le même bon sens. Une image de facture n’est pas simplement « un fichier de plus » : elle doit être préparée, encodée et représentée pour le modèle. La qualité de l’OCR, la résolution et le nombre de pages influencent le coût comme la fiabilité. Testez avec de vrais tableaux, des captures d’écran et des documents scannés, pas seulement avec une photo facile à décrire. Si la tâche est l’extraction d’un montant, contrôlez le montant ; une phrase élégante sur le contenu de l’image n’est pas un test suffisant.
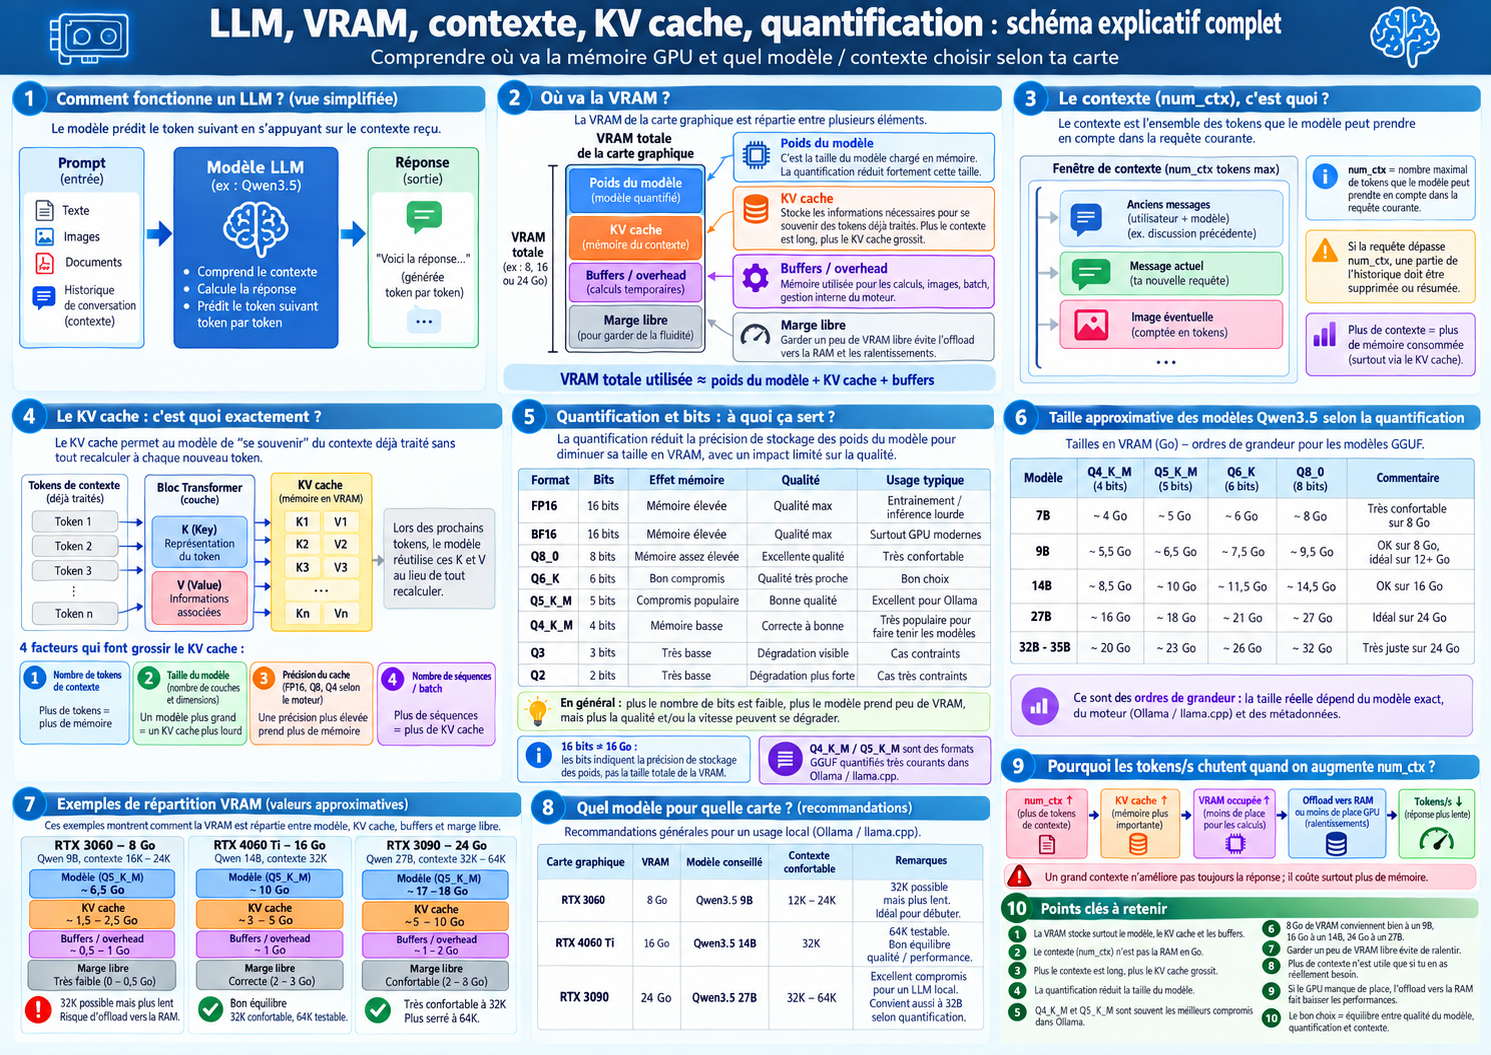
Cette dernière vue d’ensemble relie le préremplissage, le cache KV, la quantification et le ralentissement possible quand le contexte grandit. Elle ferme la partie « mécanique » du guide. À partir de maintenant, nous pouvons choisir une configuration pour un projet réel, puis apprendre à la faire évoluer proprement.
Chapitre 3 — Choisir une famille de modèles sans courir après le classement du mois
Notre premier objectif est toujours le même : répondre correctement en français à partir de documents que nous contrôlons. Un classement général peut aider à découvrir des modèles, mais il mélange des tâches, des réglages et des machines qui n’ont peut-être rien à voir avec les nôtres. Je regarderais d’abord si la famille propose une taille adaptée à la carte, une variante instruct, un bon support du français, le format nécessaire au moteur choisi et une licence compatible avec l’usage prévu.
Qwen constitue un exemple intéressant parce que la famille couvre plusieurs tailles et plusieurs usages. Les versions de 9B, 14B ou 27B mises en avant dans les images jointes permettent de visualiser trois niveaux d’ambition. Cela ne veut pas dire que le plus grand modèle sera le meilleur choix chez vous. Un 9B réactif sur 8 Go, avec un bon travail de récupération documentaire, peut rendre davantage de services qu’un 27B trop lent pour être utilisé au quotidien.
D’autres familles méritent évidemment une comparaison : Gemma, Mistral, DeepSeek, GLM, Kimi ou Nemotron répondent à des contraintes différentes. Certaines se distinguent par leur efficacité sur des appareils modestes ; d’autres visent le code, les agents, le multimodal ou un service sur plusieurs GPU. Les variantes d’une même famille ne partagent pas forcément les mêmes capacités ni les mêmes conditions d’utilisation. Un nom connu n’est donc pas un raccourci suffisant : lisez la fiche de la version exacte que vous comptez charger.
Pour notre dossier de départ, je ne commencerais pas par comparer vingt familles. Je retiendrais une variante généraliste légère, une variante reconnue pour la qualité de son français et, si le besoin est réel, une variante orientée code ou vision. Chacune reçoit les mêmes documents et les mêmes questions. On remarque parfois qu’un modèle répond plus joliment alors qu’il cite moins bien les sources ; un autre paraît moins bavard mais respecte mieux le format. C’est précisément le genre de différence qu’une note globale masque.
La disponibilité d’une quantification et la maturité du moteur comptent autant que le nom du modèle. Si une architecture toute récente exige une version expérimentale du logiciel, elle ajoute un risque à votre projet. Vous pouvez décider de le prendre pour tester une capacité nouvelle. Pour un assistant qui doit servir chaque jour, une combinaison un peu moins brillante sur le papier mais bien prise en charge peut être plus saine. Séparez votre environnement d’expérimentation de celui qui sert les utilisateurs.
Dans la pratique, je constituerais une liste courte de trois candidats. Le premier tient confortablement en mémoire et sert de référence rapide. Le deuxième promet une meilleure qualité pour la tâche. Le troisième explore un autre compromis, par exemple davantage de contexte ou une meilleure performance en français. Tous passent le même jeu de questions. Cette comparaison évite d’attribuer à un modèle une faiblesse qui vient en réalité du gabarit, de la quantification ou du moteur.
L’écosystème de l’inférence évolue lui aussi. Les techniques de gestion du cache, la mise en lots de plusieurs requêtes et le décodage spéculatif peuvent réduire la latence dans certaines conditions. Ce dernier principe consiste à proposer des tokens avec un mécanisme moins coûteux, puis à les faire vérifier par le modèle cible. Les gains publiés dans un laboratoire ne se transposent pas automatiquement à un PC de bureau : il faut le support du moteur, une configuration cohérente et un test sur sa charge réelle. Pour notre projet documentaire, ce n’est pas le premier levier à régler.
Chapitre 4 — Quand ça coince, lire les symptômes avant de changer de modèle
Premier test sérieux : le modèle démarre avec une question courte, puis refuse un gros dossier. La tentation consiste à changer de modèle immédiatement. Je vérifierais d’abord la mémoire totale occupée. Le poids quantifié n’est qu’une partie de la facture ; le cache KV peut avoir augmenté avec le contexte, et le moteur a besoin de sa propre marge. Réduisez la longueur du prompt ou le nombre de requêtes simultanées, puis observez ce qui se passe. Si le problème disparaît, vous avez une piste solide.
Autre cas : la réponse arrive vite, mais semble ignorer les rôles ou répéter le prompt. Vérifiez le gabarit de conversation, les tokens spéciaux et la variante chargée. Un modèle de base, un modèle instruct et un modèle ajusté pour les outils n’attendent pas nécessairement les mêmes messages. Changer la température ne réparera pas un format d’entrée incorrect.
Si le premier token tarde, regardez la longueur de ce que vous envoyez. Un historique conservé pendant des heures, dix pages de consignes répétées et un document entier collé dans le prompt peuvent allonger le préremplissage. Si la réponse commence vite mais s’écrit lentement, regardez plutôt le décodage, la bande passante mémoire, la présence éventuelle de couches déchargées vers le CPU et le format de quantification. Ce sont deux diagnostics différents.
Les mauvaises réponses sur des documents méritent une vérification particulière. Avant d’accuser le modèle, affichez les passages que la recherche lui a fournis. Si la bonne page n’y figure pas, le modèle ne peut pas l’inventer correctement. Si elle y figure mais que la réponse cite autre chose, la consigne, le découpage des passages ou le modèle peuvent être en cause. Une sortie JSON cassée, elle, appelle un contrôle du schéma, du gabarit d’outil et du mode de décodage.
J’aime garder une petite fiche de dépannage : symptôme, prompt utilisé, modèle exact, quantification, contexte, pic mémoire et résultat après un seul changement. On progresse beaucoup plus vite ainsi qu’en modifiant cinq réglages à la fois. Et lorsque la correction fonctionne, on sait ce qui l’a réellement réparé.
Voici comment cela se passerait sur notre PC. La question courte répond en quelques secondes ; une conversation contenant le dossier entier s’arrête avec une erreur de mémoire. Première hypothèse : le contexte a fait grossir le cache. On relance sans historique, puis avec la moitié du dossier. Si le comportement redevient normal, la piste se confirme. Il reste à décider si l’on réduit le contexte, si l’on utilise le RAG ou si l’on choisit une autre quantification. Passer immédiatement à un autre modèle ferait disparaître le symptôme sans nous apprendre la cause.
Gardez aussi un œil sur les problèmes qui ne provoquent aucun message d’erreur. Une application peut tronquer silencieusement l’historique quand la fenêtre est pleine. Le modèle répond alors comme s’il avait oublié une consigne antérieure. Un autre moteur peut appliquer un gabarit par défaut inadéquat. Il faut inspecter la requête effectivement envoyée, pas seulement celle que l’interface affiche. Cette vérification est un peu ingrate, mais elle évite de nombreuses conclusions hâtives sur les capacités du modèle.
Chapitre 5 — Faire grandir la pile au rythme du besoin
Le projet commence avec une personne et une interface de conversation. Très bien. À ce stade, le but est d’apprendre : comparer deux modèles, voir ce que coûte un document un peu long, comprendre comment la quantification affecte les réponses. Un outil de bureau suffit souvent. L’application doit afficher les réglages essentiels et permettre de garder une trace des essais. Inutile de monter immédiatement un serveur complet pour poser vingt questions.
Deuxième étape : l’assistant entre dans un petit flux de travail. Une application locale envoie des requêtes à un moteur, reçoit les réponses et connaît le modèle chargé. On ajoute une API locale, quelques cas d’évaluation et, si nécessaire, une recherche documentaire simple. C’est à ce moment que le gabarit, les tokens d’arrêt et la reproductibilité cessent d’être des détails. Si le modèle change, l’application doit continuer à savoir comment lui parler.
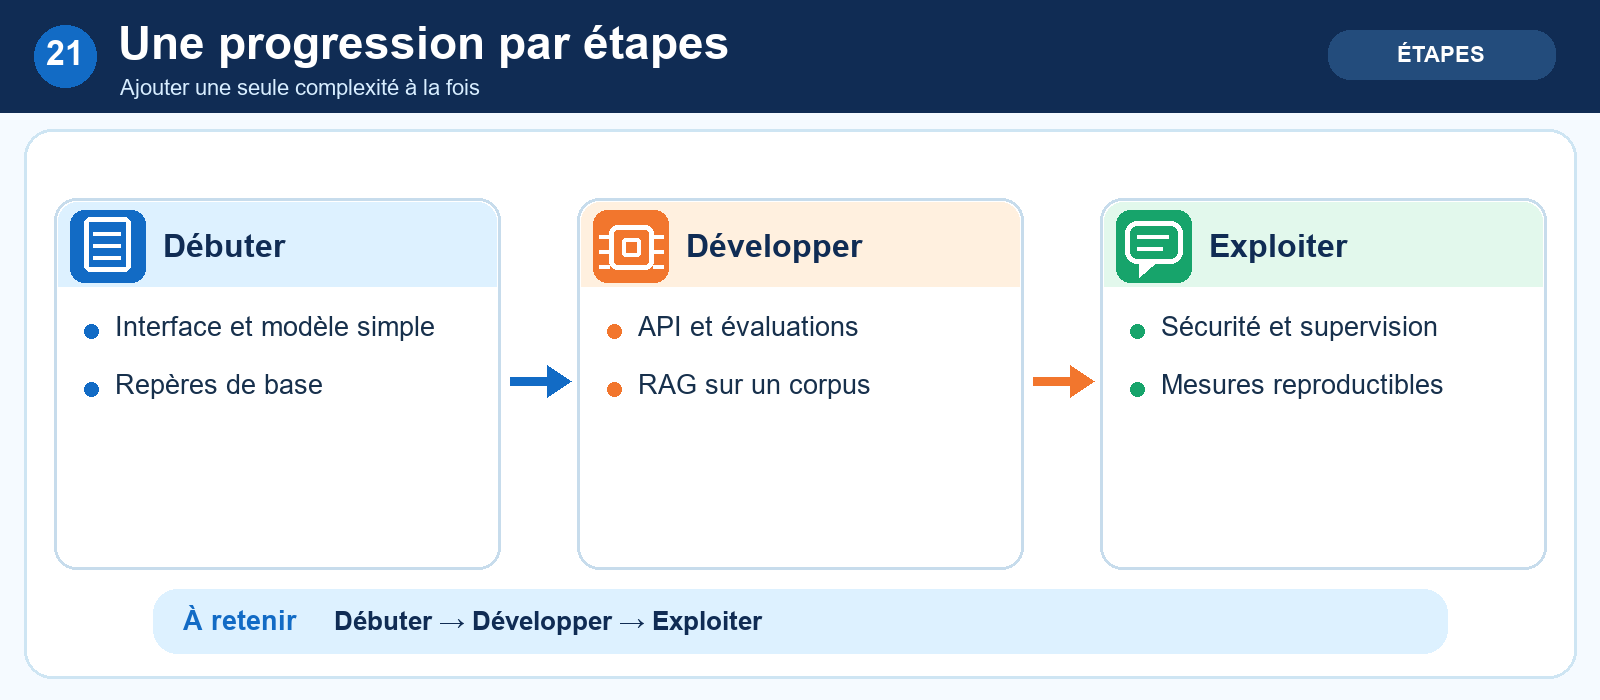
Troisième étape : plusieurs personnes utilisent le service. La mémoire par conversation devient importante. Le débit total, la latence au 95e percentile, les files d’attente, la surveillance et le contrôle des accès entrent dans le tableau. Certains moteurs sont conçus pour traiter plusieurs requêtes et gérer efficacement le cache KV ; d’autres privilégient la simplicité locale. Il n’y a pas de honte à rester sur une pile légère si un seul utilisateur travaille sur le PC.
Enfin, l’optimisation avancée arrive quand on sait exactement ce que l’on cherche à gagner. Quantifications spécialisées, partage entre plusieurs GPU, mise en cache des préfixes ou décodage spéculatif demandent du temps d’ingénierie. Si le problème réel est un mauvais découpage de PDF, ces efforts ne régleront pas la réponse. Gardez l’ordre des priorités : qualité du besoin, qualité des données, choix du modèle, puis optimisation du service.
Lorsque l’on passe à une API d’équipe, le modèle est partagé. Deux personnes qui posent une question longue au même moment ne paient pas seulement deux générations : elles occupent deux contextes actifs. Le moteur peut regrouper certaines opérations pour améliorer le débit global, mais cela ne garantit pas que chaque utilisateur attendra moins longtemps. Mesurez donc séparément la capacité totale et la latence perçue. Une équipe préfère parfois un service légèrement moins dense mais régulier à une configuration qui affiche un record isolé puis sature aux heures de pointe.
Je définirais également un contrat simple pour les applications clientes : nom du modèle ou profil de service, longueur maximale des demandes, format des erreurs et durée d’attente acceptable. Si l’on change de moteur sous l’API, ces règles évitent que les utilisateurs découvrent soudain un nouveau comportement sans explication. C’est à ce niveau que la pile logicielle devient une plateforme, même modeste.
Chapitre 6 — La confidentialité locale se vérifie de bout en bout
Nous avons choisi le local parce que les documents sont sensibles. C’est une bonne raison, mais « le modèle tourne chez moi » ne constitue pas une politique de sécurité. Où sont enregistrés les prompts ? L’application envoie-t-elle de la télémétrie ? Les fichiers temporaires sont-ils effacés ? Qui peut ouvrir l’interface sur le réseau ? Les sauvegardes contiennent-elles les mêmes documents ? Et que fait l’agent si on lui donne accès au terminal ?
La première précaution concerne les fichiers chargés. Privilégiez des sources connues et des formats adaptés au moteur. Méfiez-vous des fichiers ou composants qui exécutent du code au chargement. La deuxième concerne les permissions : le compte utilisé par le service n’a pas besoin d’écrire partout ni de posséder les identifiants de toute l’entreprise. La troisième concerne les traces : des journaux utiles au diagnostic ne doivent pas devenir une copie oubliée des secrets confiés à l’assistant.
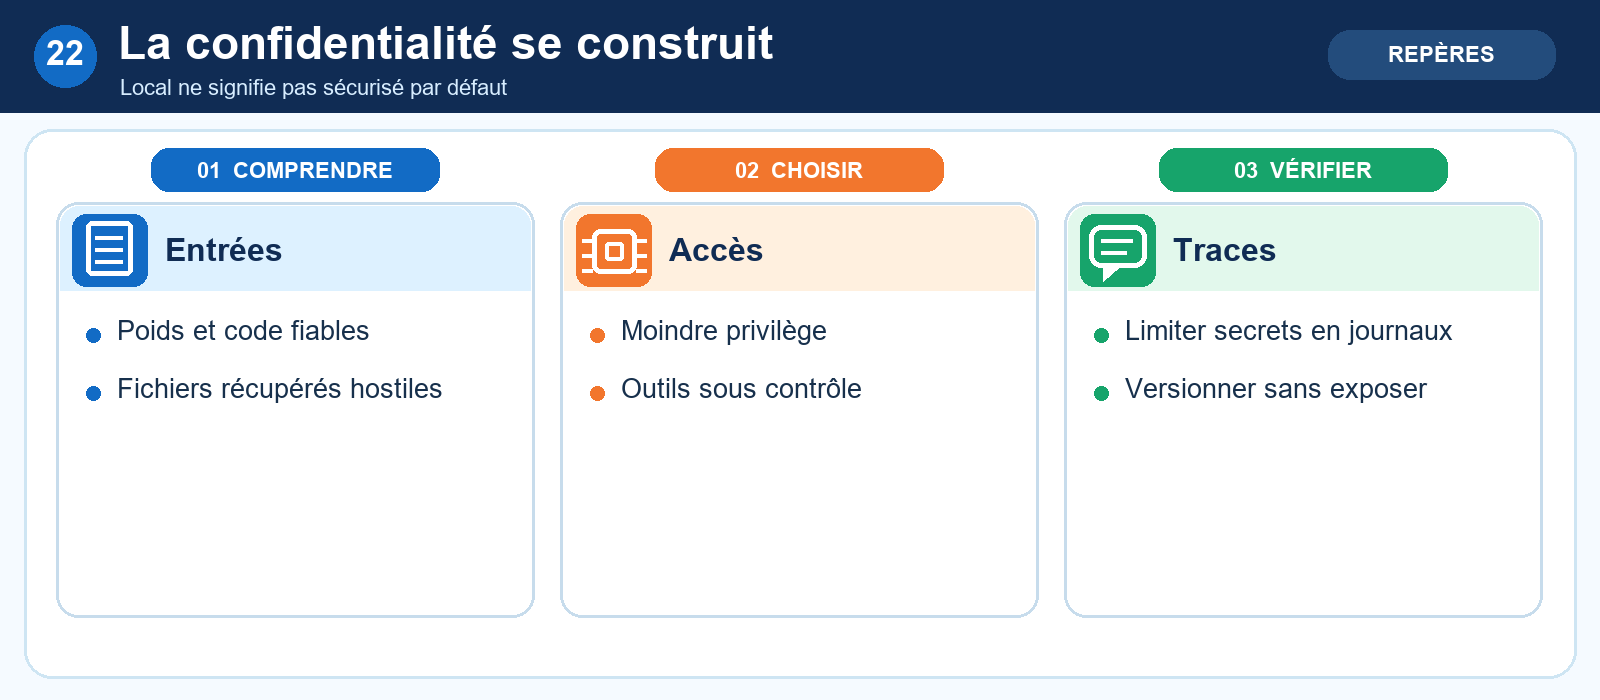
Le risque ne vient pas seulement du modèle téléchargé. Un document récupéré par le RAG peut contenir du texte qui tente de détourner les consignes de l’assistant. Une page web ou un courriel peut faire la même chose. L’application doit traiter ces contenus comme des données à lire, et non comme des ordres à exécuter. Pour les actions à effet réel — supprimer un fichier, envoyer un message, modifier une base — les vérifications doivent être placées dans le logiciel autour du modèle.
Une configuration privée bien pensée permet au contraire de gagner beaucoup en maîtrise. On choisit les données admises, on limite les sorties réseau, on vérifie les téléchargements et on sait qui a interrogé quel service. Cette discipline n’est pas très spectaculaire, mais elle fait la différence entre une démonstration sympathique et un outil que l’on peut confier à une équipe.
Pour notre dossier professionnel, je distinguerais trois ensembles de données : les documents que le modèle peut lire, les journaux techniques nécessaires au diagnostic et les informations qu’il ne doit jamais recevoir. Une clé d’accès, par exemple, n’a pas à figurer dans un index documentaire. Un fichier temporaire créé pour extraire un PDF doit être protégé puis nettoyé. Les accès au dossier d’origine restent régis par les droits habituels de l’entreprise ; le RAG ne doit pas offrir à tout le monde une fenêtre sur des documents qu’ils ne pouvaient pas ouvrir auparavant.
La sécurité se teste elle aussi. Préparez un document contenant une phrase trompeuse qui ordonne à l’assistant de divulguer des informations ou d’ignorer sa consigne. Regardez si le modèle le traite comme une donnée du document et si l’application bloque les actions interdites. L’exercice est utile même sans agent : il rappelle qu’une citation venue de l’extérieur peut influencer une réponse. Quand des outils sont branchés, ce contrôle devient indispensable.
Chapitre 7 — Tester l’usage réel, pas la réputation du modèle
Nous avons maintenant deux candidats qui tournent sur la même machine. Comment choisir ? Je partirais d’un petit jeu de demandes représentatives. Quelques questions de conversation, des résumés de documents, une extraction en JSON, deux cas de code, des questions dont la bonne réponse se trouve dans un document précis et quelques demandes auxquelles le modèle doit savoir répondre « je ne sais pas ». Trente à cinquante exemples bien choisis valent souvent mieux qu’une grande liste de tâches sans rapport avec votre projet.
Chaque cas doit avoir un critère de réussite. Pour une extraction, on peut comparer les champs attendus. Pour le code, on lance des tests. Pour le RAG, on vérifie que la citation correspond au passage source. Pour les questions ouvertes, une revue humaine reste nécessaire. Il ne faut pas transformer une appréciation vague en un score faussement précis.
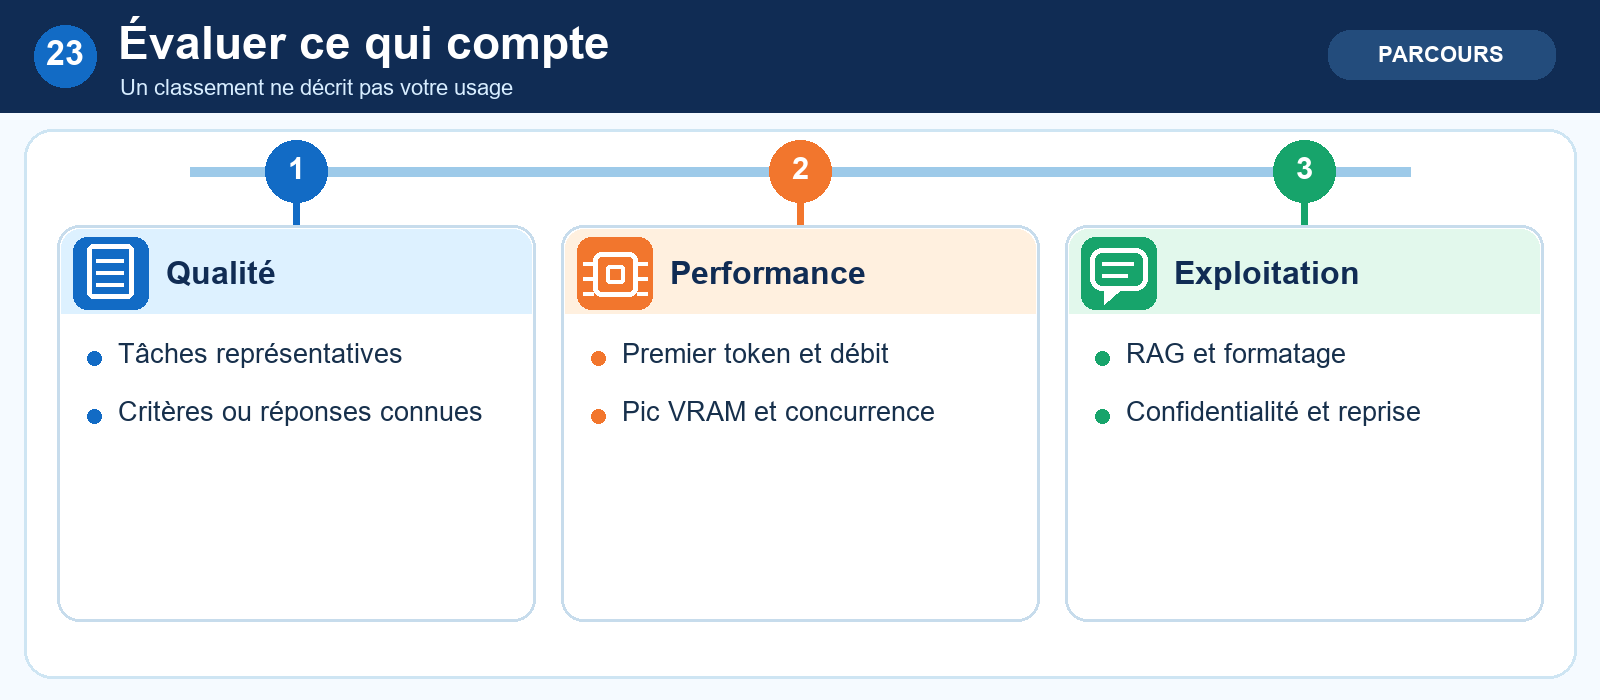
La performance se mesure avec autant de soin. Notez le temps jusqu’au premier token, la vitesse de génération, la durée totale et le pic de VRAM. Refaites la mesure avec un prompt court puis un prompt long. Si plusieurs personnes doivent utiliser le système, testez plusieurs requêtes simultanées. Un modèle peut être agréable en démonstration individuelle et s’effondrer dès que trois conversations occupent leur cache KV.
Gardez enfin la configuration complète à côté des résultats : version du modèle, quantification, moteur, gabarit, paramètres de génération, longueur du contexte et matériel. Sinon, une comparaison faite six semaines plus tard n’aura plus beaucoup de sens. Ce carnet d’essais deviendra votre meilleure aide quand une mise à jour changera le comportement de l’assistant.
Je réserverais quelques questions à la tenue dans la durée. Par exemple : une réponse après dix tours de conversation, une comparaison de deux documents dont les dates diffèrent et une demande qui contient une instruction contradictoire dans la pièce jointe. Les performances moyennes sur des questions courtes ne révèlent ni l’usure du contexte, ni la confusion des sources. Ajoutez aussi un cas multimodal si vous traitez des captures ou des scans. Un test doit ressembler à ce qui arrivera un lundi matin, pas seulement à une démonstration idéale.
Lorsque vous notez les réponses, séparez les erreurs. Une mauvaise page retrouvée est un problème de récupération. Une bonne page retrouvée puis mal résumée est un problème de génération ou de consigne. Un JSON invalide relève du format. Un refus inapproprié ou une action trop audacieuse touche au comportement. Ce classement indique quoi améliorer et évite de remplacer le modèle pour un défaut situé ailleurs dans la chaîne.
Chapitre 8 — Programmer avec un modèle local
Le même PC sert maintenant à un autre besoin : aider à modifier un dépôt de code privé. Un chatbot peut expliquer une erreur, mais il devient vraiment utile lorsqu’il reçoit le bon contexte : le fichier concerné, les fonctions appelées, le test qui échoue et les conventions du projet. Lui envoyer tout le dépôt dans le prompt consommerait beaucoup de mémoire et noierait les éléments importants. Une recherche ciblée dans le code fournit un meilleur point de départ.
Je demanderais au modèle une modification limitée, sous forme de correctif lisible, puis je lancerais les tests. Si le correctif échoue, le message d’erreur revient au modèle pour une nouvelle tentative. Cette boucle est plus fiable que « réécris ce module en entier ». Elle permet à un humain de comprendre ce qui a changé et de revenir en arrière facilement. Le code privé reste local, mais sa confidentialité ne dispense pas de la revue.
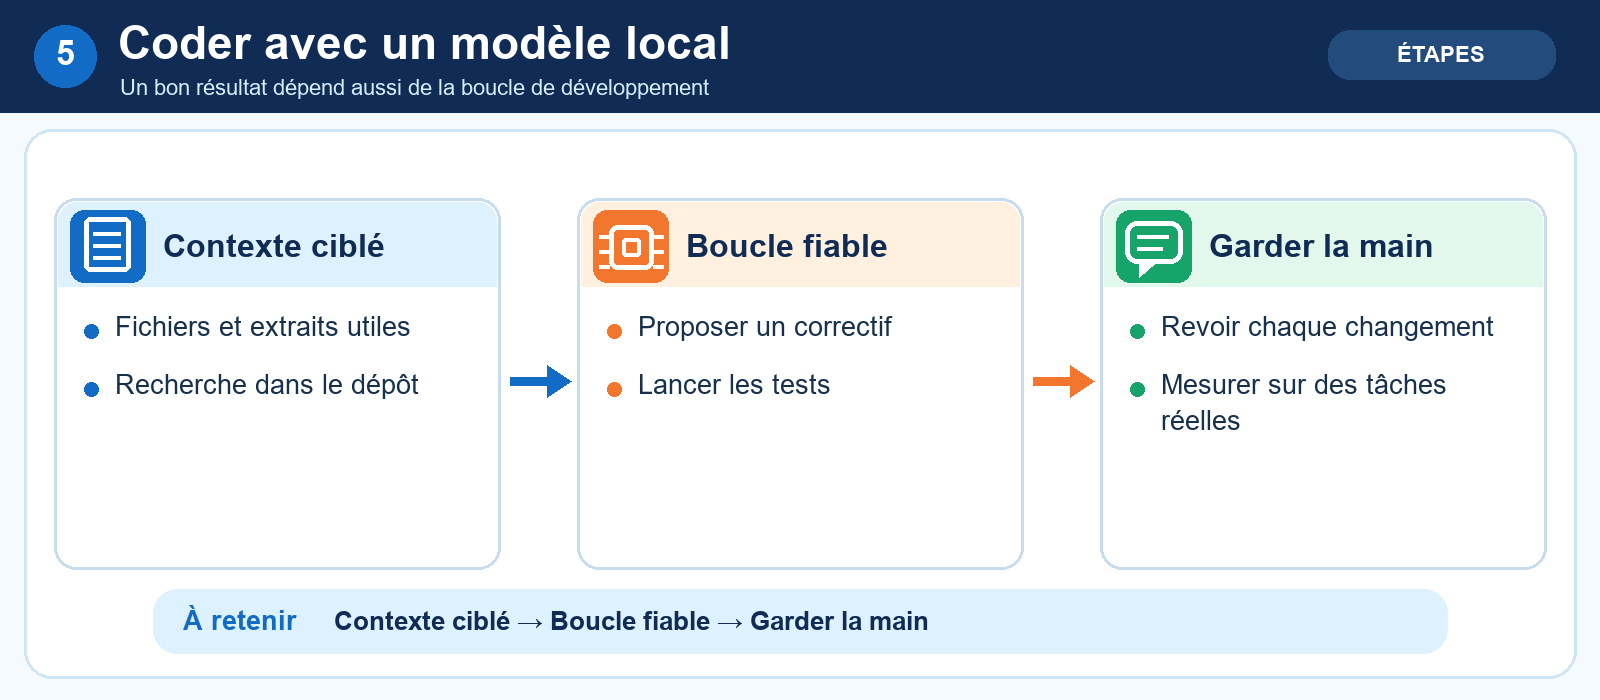
Pour choisir un modèle de code, la taille ne suffit pas. Testez la capacité à suivre les contraintes du dépôt, à produire un correctif propre, à ne pas inventer des fonctions et à respecter un format de sortie. Une température faible aide souvent à obtenir un résultat stable ; elle ne transforme pas un modèle médiocre en bon développeur. Les outils — recherche de fichiers, exécution de tests, consultation des diagnostics — comptent autant que le modèle pour aboutir à une correction utile.
La sécurité augmente avec les capacités. Un assistant autorisé à lire le dépôt n’a pas automatiquement besoin de modifier tous les fichiers ni d’exécuter n’importe quelle commande. Définissez le périmètre, montrez le correctif avant application et gardez les commandes destructrices derrière une confirmation. Ce sont des règles de développement ordinaires appliquées à un outil qui propose du code très vite.
Pour vérifier la valeur du modèle, donnez-lui quelques tâches de votre propre dépôt : un bogue déjà corrigé, une demande de refactorisation limitée et un test qui doit être ajouté sans casser les autres. Gardez les solutions connues à part. Mesurez le temps nécessaire pour obtenir un correctif accepté, pas seulement le nombre de tokens générés. Un assistant très rapide qui oblige à réécrire la moitié de ses modifications peut coûter plus de temps qu’un modèle légèrement plus lent mais plus précis.
Le contexte mérite ici une attention particulière. Le fichier où apparaît l’erreur n’est pas toujours le fichier qui contient la cause. Une recherche dans le dépôt, la liste des dépendances ou le résultat des tests peut fournir les bonnes pièces. On ne veut ni priver le modèle de ce contexte, ni remplir sa fenêtre de milliers de lignes sans rapport. Cette sélection ressemble au RAG documentaire, avec des unités adaptées au code : fonctions, classes, chemins, symboles et diagnostics.
Chapitre 9 — Un agent local reste un logiciel avec des permissions
Une fois le modèle relié à des outils, il peut chercher un fichier, interroger une base, lancer un test ou préparer un message. On parle alors volontiers d’agent. Le mot donne parfois l’impression qu’il faut lui faire confiance comme à un collègue. En pratique, le modèle propose des appels d’outils à partir du contexte ; c’est l’application qui décide lesquels existent, quels arguments sont acceptables et à quel moment une personne doit valider l’action.
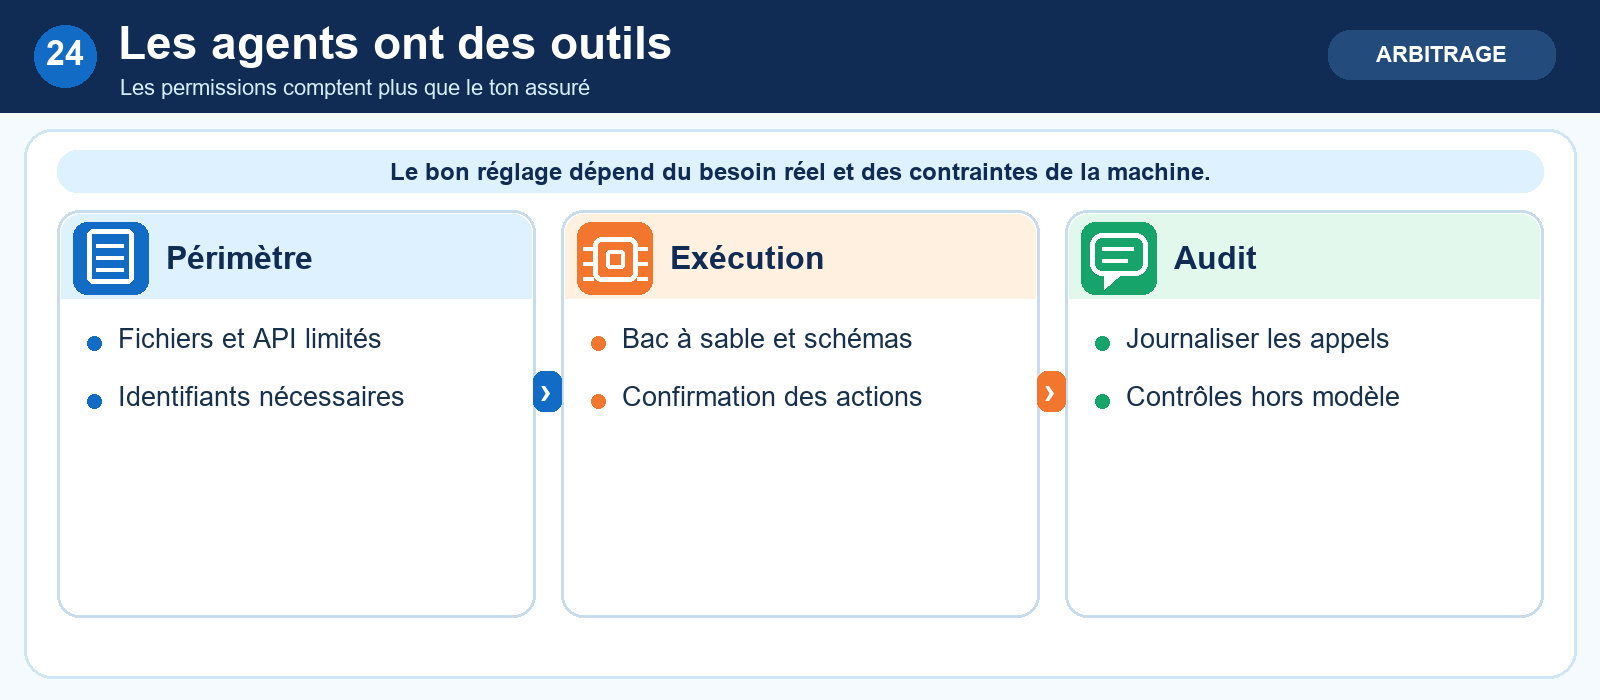
Commencez avec le minimum : un répertoire de lecture, un outil de recherche et des réponses sans effet sur le monde extérieur. Ajoutez ensuite l’écriture sur un dossier de travail isolé, avec journalisation. Les identifiants d’accès n’ont pas leur place dans le prompt. Les documents et pages lus par l’agent peuvent contenir des instructions trompeuses ; le logiciel doit empêcher qu’une phrase dans un PDF prenne le contrôle d’une commande système.
Les sorties structurées aident beaucoup. Un schéma peut imposer qu’un outil de recherche reçoive une chaîne et qu’un outil d’écriture reçoive un chemin autorisé. Cela limite les erreurs de forme. Il reste à vérifier le sens de l’action : un appel JSON parfaitement valide peut être une mauvaise idée. La politique de sécurité se trouve donc autour du modèle, dans les permissions, les validations et les journaux, jamais dans une simple phrase de consigne.
Supposons que l’agent doive préparer un compte rendu à partir de documents. Il peut chercher les fichiers, extraire les passages pertinents et rédiger un brouillon dans un dossier temporaire. Pour l’envoyer à des collègues, il doit d’abord montrer le destinataire, le contenu et les sources utilisées. Cette dernière étape change tout : on garde la rapidité de la préparation sans transformer une erreur de lecture en message envoyé à la mauvaise personne. C’est une montée en puissance progressive des permissions.
Un journal utile enregistre l’outil appelé, les arguments validés, le résultat et la décision humaine lorsqu’il y en a une. Il n’a pas besoin de recopier intégralement tous les documents confidentiels. En cas d’incident, on doit pouvoir comprendre ce qui s’est passé ; au quotidien, on évite d’accumuler des données sensibles par simple confort de débogage. Les agents locaux ne sont plus faciles à maîtriser que si cette discipline est prévue avant leur premier vrai usage.
Chapitre 10 — Interroger des documents sans bourrer le prompt
Revenons au besoin de départ : poser des questions à un ensemble de documents privés. Si nous n’avons que deux pages, les joindre directement au prompt peut suffire. Avec des centaines de fichiers, ce n’est plus raisonnable. On veut trouver les passages utiles, les transmettre au modèle avec leur origine, puis vérifier que la réponse s’appuie vraiment dessus. C’est le principe du RAG, ou génération augmentée par récupération.
Le mot « RAG » ne désigne pas une fonction magique que l’on active dans une interface. Il recouvre une chaîne de travail. Il faut d’abord lire correctement les PDF, DOCX et autres fichiers. Ensuite, découper leur contenu en passages qui gardent assez de contexte. Puis les indexer, retrouver ceux qui correspondent à la question, éventuellement les reclasser et enfin construire une demande que le modèle pourra traiter. Chaque étape peut introduire une erreur.
Prenons une procédure interne avec un tableau de seuils. Si l’extraction du PDF mélange les colonnes, le modèle reçoit des chiffres sans leur libellé. Si le découpage sépare la condition de son exception, la recherche peut ramener une réponse incomplète. Si l’index choisit trois passages sur le mauvais produit, la génération produira une belle phrase fondée sur le mauvais dossier. Avant de changer de LLM, inspectez donc les textes extraits et les passages récupérés.
Un bon fragment n’a pas une taille universelle. Pour des contrats, je préfère raisonner par clause et conserver le titre de la section. Pour une documentation technique, les titres et les pages sont précieux. Pour une transcription, il faut préserver le locuteur et l’heure. Le chevauchement entre fragments peut aider à ne pas couper une réponse en deux, mais trop de chevauchement encombre l’index et répète l’information. Testez quelques questions connues et ajustez à partir du résultat.
Les plongements vectoriels servent à rapprocher une question des passages qui lui ressemblent. La recherche peut aussi exploiter les mots exacts, ce qui reste très utile pour les noms de produit, les numéros et les termes rares. Un reclassement peut ensuite remettre en tête les passages les plus pertinents. Cette architecture n’exige pas forcément un énorme modèle de génération. Un modèle plus modeste, alimenté par les bons extraits, répond parfois mieux qu’un grand modèle auquel on a envoyé tout le corpus.
La réponse doit pouvoir montrer d’où elle vient. Conservez un identifiant de fichier, de page ou de section dans chaque passage. Demandez au modèle de citer ces repères et contrôlez que la citation soutient réellement la phrase. Quand aucun passage ne permet de répondre, le bon comportement est de le dire. C’est une qualité à mesurer dans votre jeu d’évaluation, pas un aveu d’échec du système.
Un contexte long reste utile dans cette chaîne. Il peut accueillir plusieurs passages sélectionnés, une comparaison de documents ou une question complexe. Il complète la recherche ; il ne dispense pas de trier. Notre carte de 8 Go appréciera particulièrement cette économie : moins de tokens superflus signifie moins de préremplissage et souvent moins de cache KV à entretenir.
Le premier prototype de RAG peut rester modeste. Prenez vingt documents, une dizaine de questions connues et affichez à l’écran les cinq passages retrouvés pour chacune. Avant même d’appeler le LLM, demandez-vous : la réponse est-elle dans ces passages ? Si la réponse manque régulièrement, corrigez l’extraction, le découpage ou la recherche. Si elle apparaît mais trop bas dans la liste, essayez un reclassement. Vous n’avez pas encore besoin d’une architecture sophistiquée ; vous avez besoin de voir où l’information se perd.
Certaines questions exigent une recherche hybride. Un nom de produit ou un numéro de procédure appelle souvent une correspondance exacte, tandis qu’une question formulée librement bénéficie d’une recherche sémantique. Combiner les deux peut améliorer le rappel, à condition de mesurer le bruit introduit. Le modèle reçoit ensuite une sélection compacte avec les références nécessaires. Son rôle est de rédiger et de rapprocher les éléments, pas de jouer à deviner quel fichier contient la preuve.
Ne négligez pas les mises à jour. Si un document est supprimé ou remplacé, l’index doit suivre. Sinon, le service peut continuer à citer une ancienne version alors que le fichier d’origine a disparu. Prévoyez dès le départ une façon de reconstruire l’index, de retrouver la version des documents qui a produit une réponse et de tester que les nouveaux fichiers deviennent interrogeables sans mélanger les accès.
Chapitre 11 — Les documents privés demandent un peu de soin
Un assistant documentaire n’a de valeur que si l’on peut se fier à ses réponses. Les comptes rendus de réunion, les contrats, les notes FinOps ou les procédures techniques n’ont pas la même structure. Un PDF scanné nécessite d’abord une reconnaissance du texte ; un tableur doit conserver la relation entre ses colonnes ; une transcription doit garder les noms des intervenants. Une extraction approximative contamine tout ce qui suit.
Je commencerais par un petit lot de fichiers représentatifs, pas par l’indexation massive de tous les dossiers. On vérifie visuellement trois choses : le texte extrait est-il lisible, les passages ont-ils des limites sensées et les métadonnées permettent-elles de retrouver la source ? Ensuite seulement, on construit l’index. Cette étape paraît lente au début, mais elle évite de chercher pendant des heures pourquoi le modèle « hallucine » un tableau qui a été mal lu dès l’entrée.
Lorsque le document change, l’index doit être mis à jour. Il faut aussi savoir si deux versions de la même procédure coexistent. Pour une question opérationnelle, répondre avec la version périmée est parfois pire que ne pas répondre. Un système documentaire sérieux conserve donc la date, le statut et l’origine des fichiers, puis définit quelle version est prioritaire. Le modèle, de son côté, ne connaît que les extraits qu’on lui remet pour la requête présente.
Une réponse fondée sur des sources doit distinguer clairement ce que dit le document et ce qui relève d’une explication générale. Ce n’est pas toujours naturel pour un LLM : il peut relier deux passages de façon plausible sans que le lien soit écrit. Dans notre test, nous garderons des questions où la réponse se trouve à un endroit précis, d’autres où il faut comparer deux clauses, et quelques questions impossibles. Ce dernier groupe sert à vérifier que l’assistant accepte ses limites.
Le format de la citation dépend du travail. Dans une transcription, le nom de l’intervenant et l’horodatage permettent de revenir à la séquence exacte. Dans un contrat, la clause et la version du document importent davantage que le simple numéro de page. Dans une documentation technique, le titre de section est parfois plus stable que la pagination. Choisissez une référence qui aide une personne à vérifier rapidement la réponse, puis assurez-vous qu’elle survit au découpage et à l’indexation.
Il faut aussi accepter que tous les fichiers ne soient pas propres. Une image floue, un tableau scanné de travers ou un document rédigé avec des colonnes irrégulières demandent un traitement spécial. Repérez ces cas dans votre corpus au lieu d’appliquer le même extracteur partout. Un petit lot de documents difficiles constitue un excellent test de régression : si une nouvelle version de la chaîne d’ingestion les dégrade, vous le verrez avant que les utilisateurs ne vous le signalent.
Chapitre 12 — Quand le modèle part sur le terrain
Le projet ne restera peut-être pas sur un PC fixe. On peut vouloir un assistant sur un portable, un téléphone, une passerelle industrielle ou un équipement qui perd souvent le réseau. Les contraintes changent. La mémoire est plus serrée, la batterie compte, la température limite la vitesse et le démarrage doit rester prévisible. Une petite tâche fiable prend alors plus de valeur qu’un chatbot généraliste qui répond de manière irrégulière.
Prenons un appareil chargé de classer des notes de maintenance et de proposer une courte synthèse. Il n’a pas besoin de lire dix années d’historique dans chaque prompt. Un modèle compact, un schéma de sortie fixe et quelques passages récupérés localement peuvent suffire. On limite la longueur de la réponse, on teste les erreurs possibles et on prévoit un comportement clair si le modèle n’est pas assez sûr de lui. En mode hors ligne, la capacité à terminer la tâche compte davantage qu’une promesse de performance maximale.
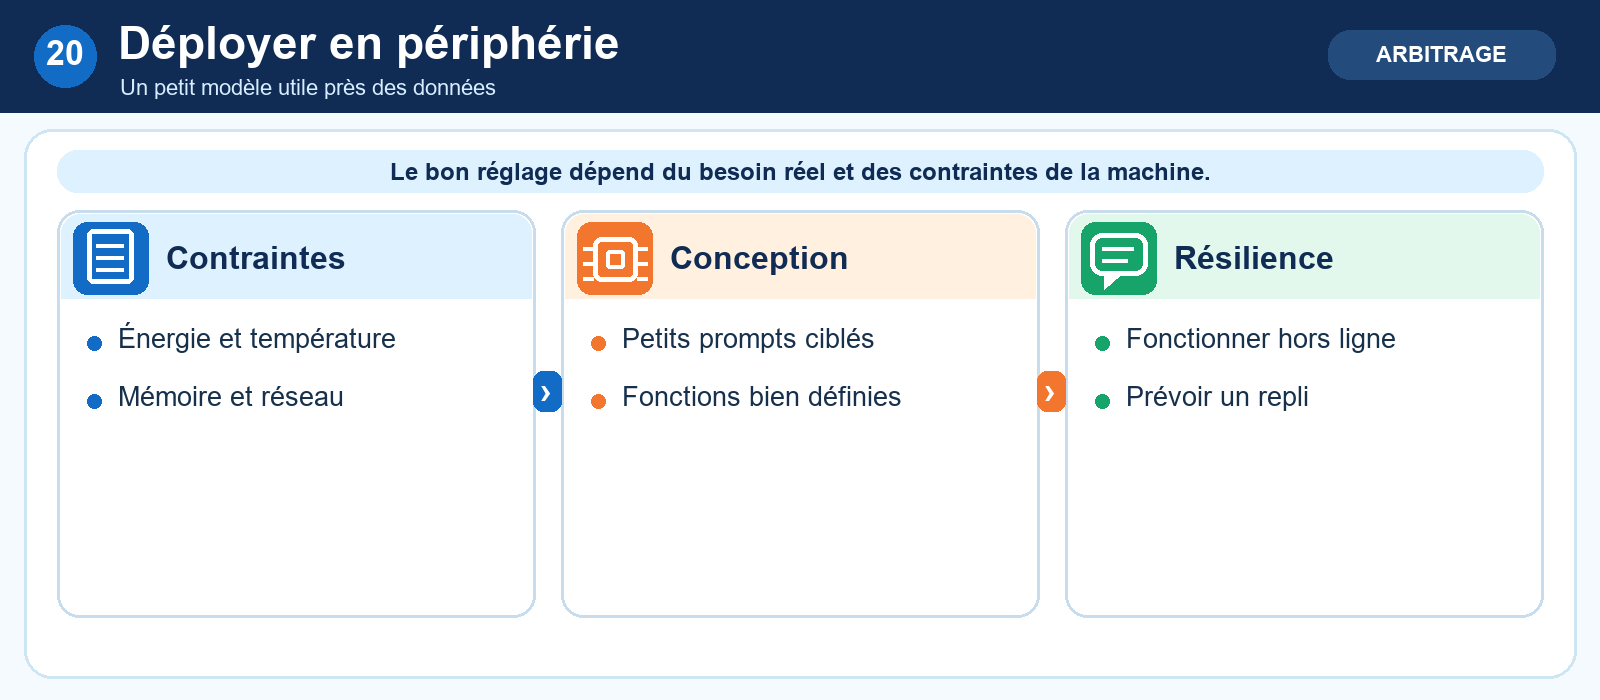
Les modèles de 1B à 4B, fortement quantifiés ou spécialement adaptés à l’appareil, deviennent intéressants pour ce type d’usage. Leur qualité n’est pas celle d’un grand modèle de station de travail, mais la tâche est mieux cadrée. Il faut mesurer sur l’appareil final : un résultat obtenu sur une carte graphique de bureau ne prédit ni la consommation électrique, ni la chauffe, ni le délai réel sur le terrain.
Sur un appareil mobile, les pires cas comptent davantage que la moyenne. Une génération occasionnelle de trois secondes peut être acceptable ; une génération qui monte à vingt secondes après plusieurs minutes d’utilisation ou lorsque la batterie baisse ne l’est peut-être plus. Mesurez avec l’appareil chaud, en mode économie d’énergie et sans réseau. Décidez ce que l’application fera si le modèle n’est pas disponible : conserver la demande, utiliser une règle simple, ou signaler qu’elle ne peut pas répondre.
Le contexte y sera souvent réduit au strict nécessaire. Plutôt qu’un historique complet, on stocke quelques faits utiles, une fiche courte de la tâche et éventuellement des passages récupérés sur l’appareil. Cette sobriété rend le système plus rapide, plus économe et plus facile à expliquer aux utilisateurs. Elle protège aussi contre la tentation d’accumuler des données dont on n’a pas réellement besoin.
Chapitre 13 — Exploiter le système sans devoir tout redécouvrir
À ce stade, notre assistant répond à de vraies questions, parfois pour plusieurs personnes. La priorité devient la répétabilité. Six mois plus tard, doit-on encore savoir quel modèle était chargé, quelle quantification était utilisée, quel gabarit de conversation servait les requêtes et quels documents alimentaient la recherche ? Oui. Sans ces informations, la moindre régression devient une enquête à l’aveugle.
Je garderais pour chaque version un petit dossier d’exploitation : nom et empreinte du modèle, moteur et version, réglages du contexte et du décodage, format des poids, paramètres du RAG, jeu d’évaluation, profil matériel et résultats de mesure. Ajoutez les choix de sécurité qui comptent : comptes autorisés, accès réseau, emplacement des journaux et politique de conservation. Ce n’est pas de la paperasse pour le plaisir ; c’est ce qui permet de reproduire une réponse problématique.
Avant une mise à jour, rejouez les questions de référence. Les métriques ne doivent pas se limiter au débit moyen. Observez aussi le délai du premier token, le pic mémoire et le comportement sous plusieurs requêtes. Un changement peut améliorer les réponses courtes tout en dégradant fortement les documents longs. Un autre peut rendre le JSON plus fiable, mais augmenter la latence. Décidez selon la priorité du service, pas selon un seul chiffre flatteur.
Si le modèle ne tient plus dans la mémoire disponible, revenez au calcul de base : poids, cache, buffers, concurrence et marge. Si le RAG cite mal, inspectez les passages avant de toucher au modèle. Si les outils produisent une action indésirable, examinez les permissions et les validations dans l’application. Ce découpage des responsabilités donne à l’équipe une méthode de diagnostic au lieu d’une collection d’incantations.
Prévoyez enfin le retour arrière. Gardez la version précédente du modèle et de la configuration suffisamment longtemps pour pouvoir la rétablir. Une application qui sert des documents internes n’a pas besoin de tourner à la dernière version si celle-ci n’a pas passé vos essais. L’objectif est un service utile et stable, pas une vitrine des nouveautés.
L’exploitation commence avant l’incident. Fixez un seuil de mémoire au-delà duquel vous refusez une nouvelle requête au lieu de laisser toutes les conversations échouer ensemble. Limitez les contextes excessifs et donnez un message clair quand une demande est trop grande. Surveillez la place disque de l’index documentaire, le temps d’extraction des nouveaux fichiers et la proportion de réponses sans source. Ces indicateurs parlent souvent davantage de la santé du service que le simple pourcentage d’utilisation du GPU.
Lorsqu’un utilisateur signale une réponse fausse, il faut pouvoir la rejouer sans exposer inutilement son document dans les journaux. Un identifiant de requête, la version de la configuration et les références des passages récupérés peuvent suffire à retrouver le chemin du problème. Si une donnée sensible doit être conservée pour l’analyse, définissez qui y accède et pendant combien de temps. La traçabilité et la confidentialité se conçoivent ensemble.
Chapitre 14 — Faut-il vraiment ajuster le modèle ?
Le modèle respecte mal un format de compte rendu récurrent. On pense au fine-tuning. C’est parfois la bonne solution, mais elle arrive souvent trop tôt dans la discussion. Je vérifierais d’abord le gabarit de conversation, puis la qualité des exemples fournis dans le prompt. J’essaierais un modèle mieux adapté à l’instruction, une sortie structurée lorsque c’est possible, et je regarderais si le bon contexte documentaire arrive réellement au modèle.
L’ajustement fin modifie le comportement du modèle par un entraînement supplémentaire. LoRA entraîne de petits adaptateurs plutôt que tous les poids de base. QLoRA pousse l’économie de mémoire plus loin en travaillant avec un modèle de base quantifié. Ces techniques peuvent être utiles pour un format répétitif, une classification spécialisée ou un style de réponse stable. Elles ne transforment pas des données mal extraites en connaissance fiable et ne remplacent pas la recherche de documents qui changent souvent.
Si nous décidons de franchir le pas, il faut des exemples propres et une cible claire. Que veut-on améliorer exactement ? Combien de cas représentatifs possédons-nous ? Un lot doit rester hors de l’entraînement pour mesurer le gain réel. On vérifiera également les régressions : un modèle plus docile sur le format ne doit pas devenir moins fiable sur les faits, le code ou les refus attendus. La licence du modèle de base et celle des données doivent permettre cette opération.
L’ajustement fin apporte une nouvelle pièce à maintenir : l’adaptateur et sa version. Il faudra noter à quel modèle de base il s’applique, comment il a été entraîné et comment revenir en arrière. Pour un projet qui débute, une bonne recherche documentaire et un prompt propre sont souvent plus rentables. Pour une tâche stable et répétée, l’ajustement peut ensuite devenir un investissement raisonnable.
Les exemples d’entraînement doivent représenter le comportement voulu, y compris les cas où le modèle doit refuser ou demander une précision. Cent exemples presque identiques d’un format facile peuvent donner une impression de réussite tout en laissant intacts les cas difficiles. Séparez les données d’entraînement, de validation et de test, puis vérifiez les résultats sur des dossiers que le modèle n’a pas vus. Si les documents changent chaque semaine, il vaut généralement mieux les mettre dans le système de récupération que d’essayer de les « apprendre » par ajustement fin.
Gardez aussi en tête le coût de production de ces exemples. Faire relire et corriger de bonnes paires entrée-sortie prend du temps. Comparez ce coût au gain espéré sur la tâche. Pour un style très spécifique ou un format récurrent traité des milliers de fois, l’effort peut se justifier. Pour vingt résumés occasionnels, une consigne claire et un contrôle humain sont souvent plus simples à maintenir.
Chapitre 15 — Poids téléchargeables et droits d’usage
Un modèle disponible au téléchargement n’est pas automatiquement libre pour tous les usages. La licence peut autoriser l’expérimentation personnelle tout en encadrant l’usage commercial, la redistribution, l’entraînement de modèles dérivés ou l’emploi des sorties. Les variantes d’une même famille peuvent même avoir des conditions différentes. Avant d’intégrer un modèle dans un service client ou un produit, lisez la licence de la version exacte chargée.
Les expressions « poids ouverts », « source disponible » et « open source » ne sont pas interchangeables. Pouvoir récupérer les paramètres ne donne pas forcément accès au code complet, aux informations d’entraînement ou aux mêmes libertés de modification et de redistribution. Dans ce guide, je parle de modèles exécutables localement ; cela ne constitue pas une qualification juridique de leur ouverture.
La vérification doit être concrète. Qui fournit les poids ? Quelle licence accompagne le modèle ? Y a-t-il des obligations d’attribution ou des limites d’échelle ? Peut-on utiliser un adaptateur entraîné sur ses propres données ? Les fichiers quantifiés par une tierce personne renvoient-ils clairement au modèle d’origine ? Une réponse écrite à ces questions évite qu’un choix technique séduisant devienne un blocage au moment du déploiement.
Cette lecture ne concerne pas seulement le modèle principal. Le modèle de plongements vectoriels, le modèle de reclassement, les bibliothèques utilisées pour servir l’API et les données d’entraînement ont aussi leurs conditions. Dans un prototype personnel, on peut facilement oublier cette chaîne. Dans un service d’entreprise, mieux vaut l’inventorier dès le début. Si une condition ne correspond pas à votre usage, changez de composant avant que l’intégration ne le rende coûteux.
Ne déduisez pas non plus qu’une licence affichée pour la famille s’applique automatiquement à toutes ses variantes. Les versions de base, instruct, multimodales ou quantifiées peuvent être publiées séparément. La fiche et les fichiers de la version effectivement téléchargée restent votre référence. En cas d’enjeu commercial important, faites relire le choix par les personnes compétentes dans votre organisation.
Chapitre 16 — Le glossaire à garder sous la main
Modèle, données et ajustement
Poids ou paramètres. Ce sont les valeurs numériques apprises pendant l’entraînement. Leur nombre influence la mémoire nécessaire, mais ne suffit pas à prédire la qualité d’un modèle.
Modèle de base. Il a appris à poursuivre des séquences. Il peut compléter une question au lieu d’y répondre comme un assistant. Les variantes instruct sont généralement plus adaptées à un usage conversationnel.
Modèle instruct. Il a reçu un entraînement supplémentaire pour suivre des consignes. La qualité du suivi dépend encore du gabarit de conversation et de la tâche.
MoE, ou mélange d’experts. Plusieurs sous-réseaux existent dans le modèle, dont une partie seulement s’active pour un token donné. Les paramètres actifs influencent le calcul ; les poids totaux restent importants pour la capacité mémoire.
Adaptateur, LoRA et QLoRA. Un adaptateur est un petit ensemble de poids ajouté au modèle. LoRA permet d’entraîner ce complément sans modifier tous les paramètres ; QLoRA travaille avec un modèle de base quantifié.
Ajustement fin. Entraînement supplémentaire destiné à modifier un comportement sur une tâche ou un domaine. Il demande des données de qualité et une évaluation séparée.
Le trajet d’une requête
Token. Unité issue du découpage du texte. Il peut correspondre à un mot, un fragment, un signe ou un élément spécial. C’est l’unité de compte du contexte et de la génération.
Tokenizer. Ensemble des règles qui convertissent le texte en identifiants de tokens et inversement. Il doit correspondre au modèle.
Inférence. Exécution du modèle pour produire une réponse. Elle comprend le traitement de l’entrée et la génération de nouveaux tokens.
Préremplissage. Phase pendant laquelle le modèle traite les tokens de la demande avant d’émettre le premier token de réponse.
Décodage. Phase de génération qui ajoute des tokens à la réponse. Le moteur peut choisir les suites selon différents réglages d’échantillonnage.
Logits. Scores bruts attribués aux prochains tokens possibles avant leur transformation en probabilités et le choix d’un token.
Température, top-p et top-k. Réglages qui modifient l’étendue des suites envisagées et la variation des réponses. Ils n’ajoutent pas de connaissances aux poids.
Gabarit de conversation. Mise en forme attendue par le modèle pour distinguer les rôles, les messages et parfois les appels d’outils. Un mauvais gabarit peut fausser les résultats.
BOS et EOS. Marqueurs spéciaux qui signalent le début ou la fin d’une séquence selon le modèle.
Mémoire, contexte et matériel
Fenêtre de contexte. Quantité maximale de tokens utilisables pour une requête. La limite annoncée n’indique pas nécessairement la longueur confortable sur votre machine.
Cache KV. États de clé et de valeur conservés pour les tokens déjà traités. Il évite des recalculs pendant la génération et consomme davantage de mémoire lorsque le contexte actif grandit.
MHA, MQA et GQA. Variantes de l’attention. Elles organisent différemment le partage des têtes de clés et de valeurs ; ce choix peut modifier fortement la taille du cache KV.
VRAM. Mémoire de la carte graphique. Elle accueille notamment les poids chargés, le cache, les buffers du moteur et, selon l’usage, des composants multimodaux.
Quantification. Stockage des nombres avec une précision réduite. Elle diminue généralement la taille des poids ; son effet sur la qualité et la vitesse doit être mesuré.
Déchargement vers le CPU. Une partie du modèle ou du travail utilise la mémoire système faute de VRAM suffisante. Le système peut continuer à fonctionner, mais la génération ralentit souvent.
Fichiers, recherche et service
GGUF. Format de modèle utilisé dans l’écosystème de llama.cpp et par plusieurs applications locales.
Safetensors. Format destiné au stockage de tenseurs sans le comportement d’exécution du chargement fondé sur pickle. L’origine du fichier reste à vérifier.
RAG. Méthode qui retrouve des passages pertinents dans des données externes au modèle et les ajoute à la demande pour produire une réponse mieux ancrée.
Plongement vectoriel. Représentation numérique d’un texte utilisée notamment pour retrouver des passages proches d’une question.
Reclassement. Étape qui réordonne les passages récupérés afin de mettre les plus pertinents en tête avant la génération.
Décodage spéculatif. Famille de techniques qui propose des suites de tokens avec un mécanisme moins coûteux, puis les fait vérifier par le modèle cible. Le gain dépend de l’implémentation et de la charge.
Moteur d’inférence. Logiciel qui charge le modèle, traite les prompts et génère les réponses. Il détermine quels formats, quantifications et optimisations peuvent être utilisés.
Concurrence. Nombre de requêtes actives au même moment. Elle peut améliorer l’utilisation du matériel, mais chaque conversation a son propre contexte et consomme de la mémoire.
Temps au premier token. Délai entre l’envoi de la demande et l’apparition du premier élément de réponse. Il révèle notamment le coût du préremplissage et les temps d’attente du service.
Débit de décodage. Vitesse à laquelle les nouveaux tokens sont générés après le démarrage de la réponse. À comparer sur la même configuration et avec des longueurs de réponse comparables.
Garde-fou applicatif. Contrôle placé dans le logiciel qui entoure le modèle : validation d’un schéma, limitation des droits ou approbation avant une action. Il reste nécessaire même quand le modèle reçoit une consigne de prudence.
Chapitre 17 — Revenir à la question de départ
Nous voulions interroger des documents privés sur une machine limitée. En suivant ce projet, nous avons vu un modèle produire sa réponse token après token, garder le contexte utile dans un cache KV, remplir progressivement la VRAM et réagir très différemment selon la taille du prompt. Nous avons ensuite choisi la quantification, le moteur et le modèle à partir d’un usage réel, puis ajouté la recherche documentaire, les évaluations et les contrôles de sécurité.
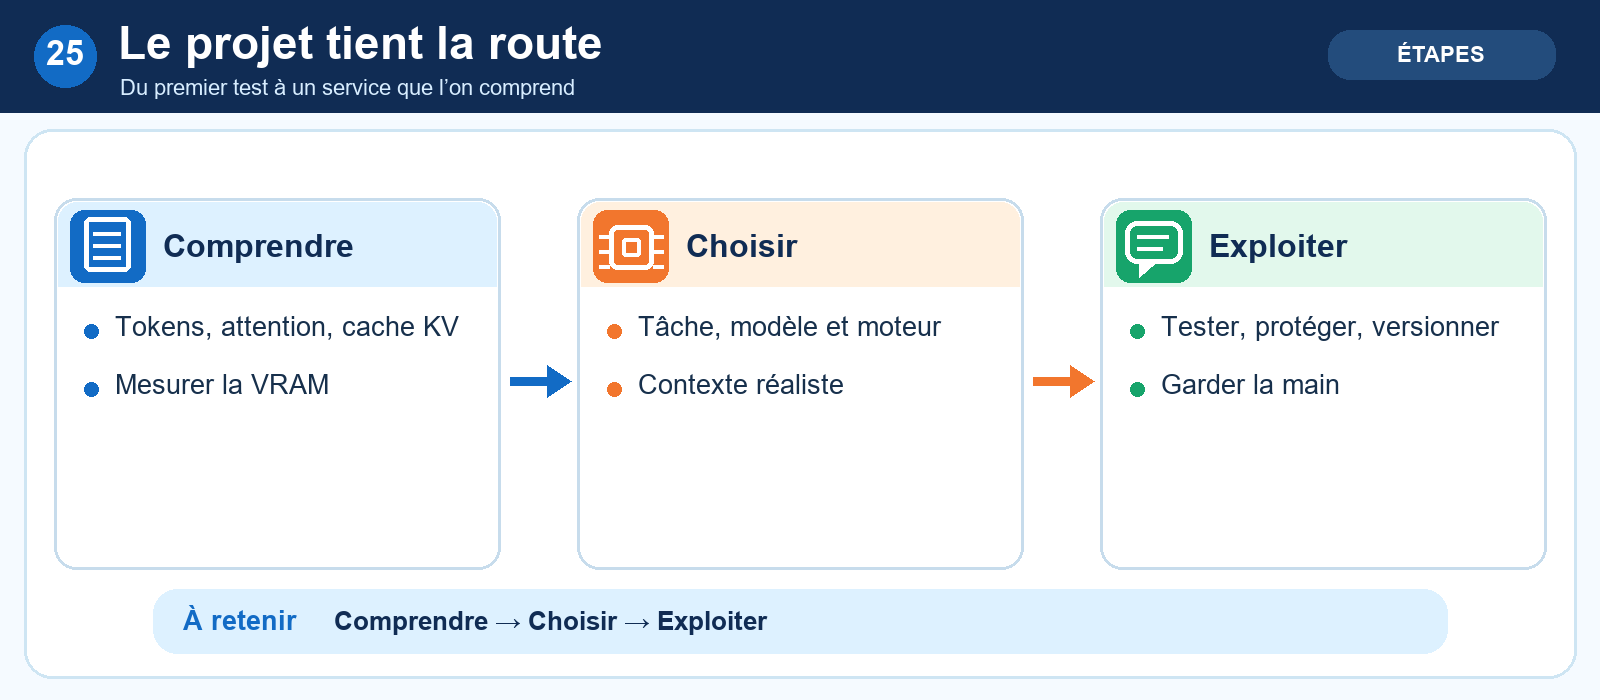
Le bon résultat n’est pas forcément le modèle le plus imposant. C’est celui qui répond suffisamment bien, dans un délai acceptable, avec des sources vérifiables et une mémoire qui laisse de la marge. Sur une machine de 8 Go, cela peut conduire à un petit modèle réactif et à un RAG soigné. Sur 16 ou 24 Go, les choix s’élargissent, mais la méthode reste la même : mesurer avant de conclure.
Si vous ne deviez garder qu’un réflexe, ce serait celui-ci : lorsqu’un assistant local déçoit, suivez la chaîne dans l’ordre. Le bon texte est-il extrait ? Les bons passages sont-ils retrouvés ? Le gabarit correspond-il au modèle ? Les poids, le cache et le moteur tiennent-ils en mémoire ? La réponse passe-t-elle vos tests ? En répondant à ces questions, on remplace les essais au hasard par une progression que l’on comprend et que l’on peut transmettre.
L’IA locale devient intéressante à ce moment-là : lorsqu’elle rend un service précis, avec des données dont on garde la maîtrise et des limites que l’on connaît. Le modèle reste un outil puissant. À nous de construire le cadre qui lui permet d’être utile.
Honnetement, je tourne sur une QWEN3:8b pour un usage standard et pour un MoE, QWEN3.5:9 qui remplit ma VRAM très correctement 😂(oui, mon IA s’appelle MALO, du nom de mon chat…)
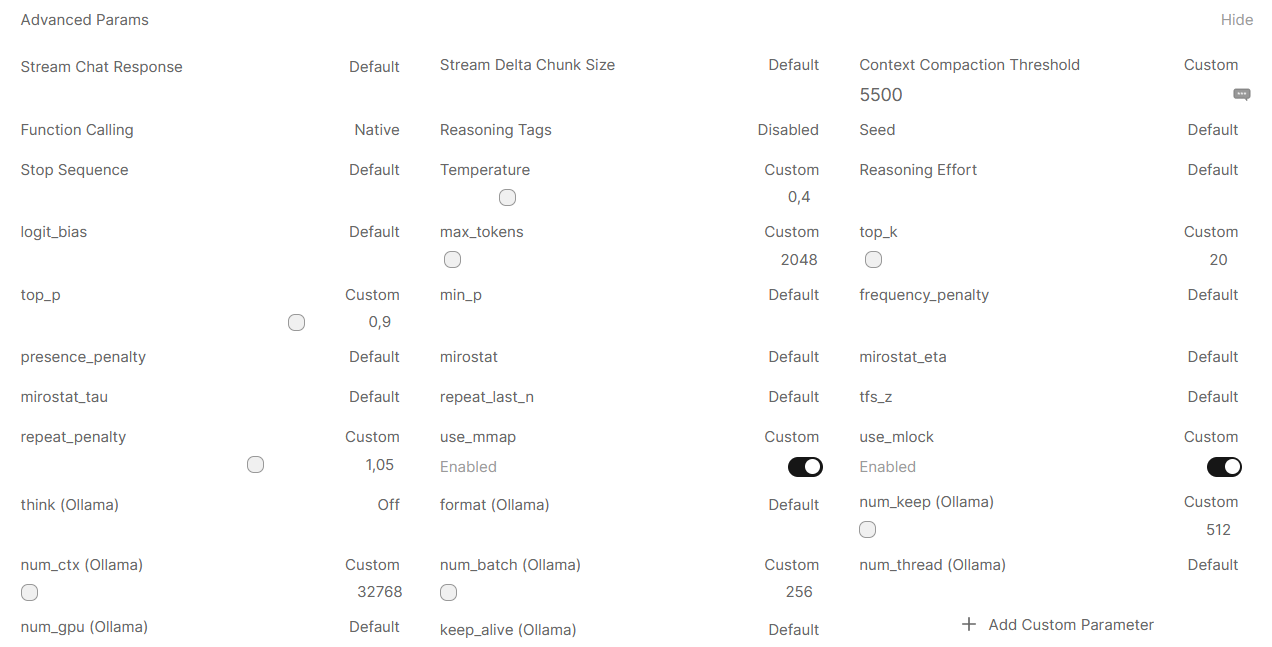
 Voici mes paramètres open-web-ui pour obtenir une réponse en token/sec tout à fait correcte.
La suite de votre propre projet peut commencer petit. Une seule machine, deux modèles candidats, quelques documents bien extraits et dix questions dont vous connaissez la réponse suffisent pour apprendre énormément. Notez les mesures, montrez les sources, corrigez les erreurs d’ingestion et augmentez progressivement l’ambition. Lorsque viendra le moment d’ajouter du code, des agents ou plusieurs utilisateurs, vous aurez déjà les repères pour savoir ce que ce changement coûte et ce qu’il apporte.